Strands Agents SDK: The Agent Loop, Hooks, and Production Controls
Cover: Herbig-Haro 46/47, NASA, ESA, CSA, J. DePasquale (STScI) (CC BY 4.0)
Contents
에이전트 루프란 무엇인가: 첫 에이전트부터 루프의 구조까지
언어 모델은 상태가 없습니다. 요청 하나를 받아 응답을 만들고 나면 그 내용을 잊어버리고, 혼자서는 행동하거나 실시간 데이터에 접근하거나 여러 단계로 이어지는 작업을 조율하지 못합니다. 에이전트는 모델을 런타임 시스템으로 감싸서 이 한계를 메웁니다. 이 런타임이 모델에 도구와 메모리, 추론을 반복하는 루프를 붙여 줍니다. Strands는 모델을 둘러싼 이 시스템을 하네스(harness)라고 부르고, "모델 + 하네스 = 에이전트"로 정리합니다. 하네스가 맡는 일은 에이전트 루프(agent loop), 도구 실행, 컨텍스트 관리, 메모리, 수명 주기 제어, 관측 가능성, 검증입니다.
Strands Agents SDK의 설계 원칙은 "모델이 주도하게 하라"입니다. 개발자는 환경과 경계를 정의하고, 작업을 어떤 순서로 풀어 갈지는 모델이 추론해서 정합니다. SDK는 플랫폼이 아니라 라이브러리여서 에이전트는 개발자의 프로세스 안에서 실행되고, 에이전트를 만들려면 Python 객체를 하나 생성하면 됩니다. 미리 띄워야 하는 호스팅 제어 플레인이나 스케줄러, 데이터베이스가 없습니다. 도구 없는 에이전트가 접속하는 외부 서비스는 모델 제공자뿐입니다.
설치
Python 3.10 이상이 필요합니다. 가상 환경을 만들어 활성화한 뒤 SDK를 설치합니다.
pip install strands-agents
첫 에이전트 실행
기본 모델 제공자는 Amazon Bedrock이고, us-west-2 리전의 Claude Sonnet 4.6을 사용합니다. 그래서 별도 패키지를 설치하거나 모델 객체를 만들 필요가 없습니다. agent.py를 다음과 같이 작성합니다.
from strands import Agent

# Bedrock이 기본 제공자이므로 모델 객체가 필요 없습니다.
agent = Agent()
agent("What is an agent harness, in one sentence?")
실행하기 전에 모델 호출 권한이 있는 AWS 자격 증명을 준비하고, Bedrock 콘솔에서 사용할 모델의 접근을 활성화해 두어야 합니다. 로컬 개발에서는 AWS_BEARER_TOKEN_BEDROCK 환경 변수에 Bedrock API 키를 넣는 방법이 가장 빠릅니다. aws configure나 IAM 역할로도 자격 증명을 줄 수 있습니다.
python -u agent.py
도구가 하나도 없지만 이 코드는 이미 루프를 갖춘 에이전트입니다. 응답은 콘솔로 스트리밍되고, 이 출력을 끄려면 Agent에 callback_handler=None을 넘깁니다.
모델은 에이전트에 건네는 객체 하나여서 제공자를 바꿔도 나머지 코드는 그대로입니다. 예를 들어 Anthropic을 쓰려면 pip install 'strands-agents[anthropic]'로 추가 패키지를 설치하고 ANTHROPIC_API_KEY를 설정한 뒤 모델 객체만 넘기면 됩니다.
from strands import Agent
from strands.models.anthropic import AnthropicModel

# 환경 변수 ANTHROPIC_API_KEY를 읽습니다.
model = AnthropicModel(model_id="claude-sonnet-5", max_tokens=4096)
agent = Agent(model=model)
agent("What is an agent harness, in one sentence?")
도구 추가하기
지금 에이전트는 모델이 이미 아는 지식으로만 답합니다. 파일을 읽거나 API를 호출하는 등 실제로 무언가를 하려면 도구가 있어야 합니다. 도구는 모델이 호출할지 말지를 스스로 결정하는 함수입니다. 아래 예제는 SDK에 포함된 file_editor 도구와 직접 만든 letter_counter 도구를 함께 붙입니다. 모델은 독스트링과 타입 힌트를 읽고 언제 이 도구를 부르고 어떤 인자를 넘길지 판단합니다.
from strands import Agent, tool
from strands.vended_tools import file_editor

@tool
def letter_counter(word: str, letter: str) -> int:
    """
    Count occurrences of a specific letter in a word.

    Args:
        word (str): The input word to search in
        letter (str): The specific letter to count

    Returns:
        int: The number of occurrences of the letter in the word
    """
    if len(letter) != 1:
        raise ValueError("The 'letter' parameter must be a single character")

    return word.lower().count(letter.lower())

agent = Agent(tools=[letter_counter, file_editor])
agent('How many letter R\'s are in the word "strawberry"? Write the answer to answer.txt.')
다시 실행하면 모델은 글자 세기에는 letter_counter를, 파일 쓰기에는 file_editor를 골라 둘 다 호출하고, 작업 디렉터리에 answer.txt가 생깁니다. 코드 어디에도 "먼저 글자를 세고 그다음 파일을 써라"라는 제어 흐름이 없습니다. 요청을 어떤 작업으로 나누고 어떤 순서로 처리할지는 모델이 정합니다.
루프는 어떻게 반복되는가
방금 실행한 에이전트 안에서는 모델 추론과 도구 사용(tool use)이 번갈아 반복되었습니다. 아래 그림에서 도구 결과가 다시 모델 입력으로 돌아가는 경로를 보면 루프 구조가 드러납니다.
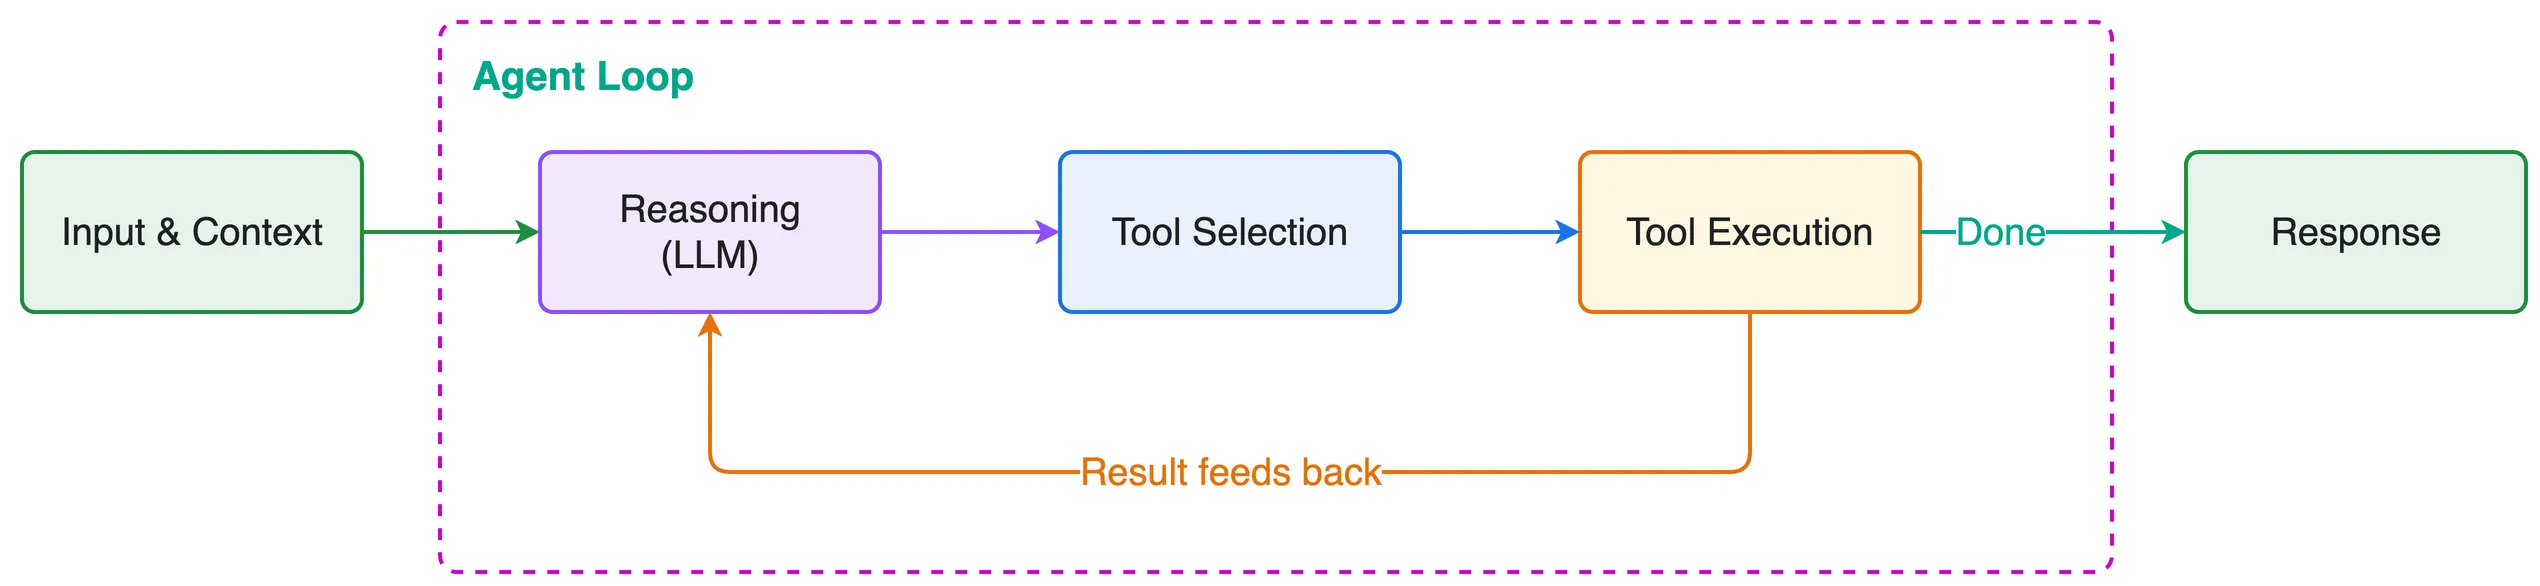
한 사이클은 다음 순서로 진행됩니다.
- 모델이 컨텍스트를 받습니다. 컨텍스트는 시스템 프롬프트, 사용자 입력, 도구 목록, 지금까지의 대화 기록으로 구성됩니다.
- 모델이 추론해서 도구를 호출할지 결정합니다.
- 도구를 호출하기로 했다면 도구가 실행되고, 그 결과가 다시 컨텍스트에 들어갑니다.
- 작업이 끝날 때까지 이 과정을 반복합니다. 모델이 도구 호출 없이 최종 메시지를 내놓으면 루프가 끝납니다.
strawberry 예제라면 개수를 알아야 파일에 쓸 수 있으므로 보통 모델은 먼저 letter_counter를 호출하고, 그 결과로 file_editor를 호출합니다. 실제 순서는 실행 뒤 agent.messages에서 확인할 수 있습니다. 이 목록에는 사용자 턴, 어시스턴트 텍스트, 도구 호출, 도구 결과가 루프가 거친 단계마다 담깁니다. 루프를 한 번 돌 때마다 이 기록이 쌓이므로 모델은 다음 사이클에서 앞 단계의 결과를 근거로 판단합니다.
기록이 계속 쌓이는 구조여서 루프가 길어질수록 컨텍스트 윈도우(context window)를 관리해야 하고, 실패 처리도 제어해야 합니다. 훅(hook), 재시도 전략(retry strategy), 대화 매니저(conversation manager)는 모두 이 반복 구조에 개입합니다. 호출이 끝날 때마다 SDK는 실행 중 오간 메시지와 메트릭, 트레이스를 담은 AgentResult를 돌려줍니다. 에이전트가 어떤 도구를 왜 호출했는지 알고 싶다면 이 결과와 agent.messages부터 확인합니다.
루프 내부 동작: 메시지, 도구 실행, 중단 이유
에이전트 루프가 한 바퀴 돌 때마다 내부에서는 세 가지가 맞물려 움직입니다. 메시지가 대화 기록에 쌓이고, 모델이 요청한 도구가 검증을 거쳐 실행되고, 모델 호출이 끝날 때마다 다음 행동을 정하는 종료 이유(stop reason)가 나옵니다. 이 세 가지를 알면 에이전트가 왜 그렇게 행동했는지, 호출이 끝난 뒤 애플리케이션이 무엇을 해야 하는지 판단할 근거가 생깁니다.
메시지의 두 역할과 대화 기록
루프를 오가는 메시지의 역할은 사용자(user)와 어시스턴트(assistant) 두 가지뿐입니다. 사용자 메시지에는 처음 요청과 이후의 지시가 담기는데, 사람이 입력한 텍스트만 들어가지는 않습니다. 앞 단계에서 실행한 도구의 결과도 사용자 메시지로 들어가고, 파일·이미지·오디오·비디오 같은 미디어도 사용자 메시지에 실립니다. 어시스턴트 메시지는 모델의 출력이며, 사용자에게 보여 줄 텍스트 응답, 실행 시스템에 보내는 도구 사용 요청, 그리고 모델이 지원하면 추론 트레이스까지 담습니다.
도구 결과가 사용자 역할로 들어가므로 대화는 늘 "어시스턴트가 도구를 요청하고, 사용자 쪽에서 결과를 돌려주는" 짝으로 이어집니다.
대화 기록은 반복마다 이 메시지들을 모두 누적합니다. 그래서 모델은 원래 요청만 보지 않고 지금까지 호출한 모든 도구와 받은 모든 결과를 함께 봅니다. 이 기록은 모델이 작업하는 동안 쓰는 작업 기억이고, 여러 단계에 걸친 추론은 이렇게 늘어나는 컨텍스트 위에서 이루어집니다. 다음 예제는 일부러 실패하는 경우가 있는 도구를 붙여 에이전트를 호출하고, 호출이 끝난 뒤 종료 이유를 출력합니다.
from strands import Agent, tool

@tool
def get_order_status(order_id: str) -> str:
    """
    Look up the shipping status of an order.

    Args:
        order_id (str): Order identifier such as "A-1001"

    Returns:
        str: The shipping status of the order
    """
    orders = {"A-1001": "shipped"}
    if order_id not in orders:
        raise KeyError(f"Unknown order id: {order_id}")
    return orders[order_id]

agent = Agent(tools=[get_order_status], callback_handler=None)
result = agent(
    "Check the status of order A-1002. If it does not exist, check A-1001 instead."
)

print(result.stop_reason)
이 호출 동안 대화 기록에는 루프가 도는 바퀴마다 무엇을 요청하고 무엇을 받았는지가 차례로 쌓입니다. 아래는 이런 실행에서 나올 법한 흐름을 손으로 따라가 본 예시입니다. 모델이 실제로 고르는 경로는 실행마다 다를 수 있습니다.
예시(설명용으로 손으로 따라간 실행):
- 사용자 메시지: 주문 A-1002를 확인하고, 없으면 A-1001을 확인하라는 요청
- 어시스턴트 메시지:
get_order_status에order_id="A-1002"를 넘기는 도구 사용 요청 → 종료 이유tool_use- 사용자 메시지:
KeyError내용을 담은 오류 결과- 어시스턴트 메시지: 같은 도구에
order_id="A-1001"을 넘기는 도구 사용 요청 → 종료 이유tool_use- 사용자 메시지:
"shipped"를 담은 성공 결과- 어시스턴트 메시지: A-1002는 없고 A-1001은 발송되었다는 최종 텍스트 → 종료 이유
end_turn
3번에서 4번으로 넘어가는 대목이 누적 기록의 효과를 가장 잘 보여 줍니다. 4번을 생성할 때 모델의 입력에는 3번의 오류 결과만 있지 않고, 1번의 원래 요청과 2번의 자기 요청이 함께 들어 있습니다. 모델은 "Unknown order id: A-1002"라는 오류 문구에서 첫 번째 주문이 없다고 읽고, 1번 요청의 "없으면 A-1001을 확인하라"는 조건과 맞춰 본 뒤 다음 행동을 고릅니다. 이 판단을 이끄는 코드는 어디에도 없고, 기록에 남은 문맥이 모델의 추론을 이끕니다.
기록이 쌓이는 구조에는 대가가 따릅니다. 도구 호출이 많은 작업에서는 기록이 모델의 컨텍스트 윈도우를 넘어설 수 있고, 그러면 에이전트가 더 진행하지 못합니다. 증상은 모델 제공자가 입력 길이 오류를 돌려주거나, 관련성이 떨어지는 오래된 메시지가 컨텍스트를 채우면서 모델 성능이 눈에 띄게 떨어지는 형태로 나타납니다. 대처 방법은 네 가지입니다. 도구가 전체 데이터 대신 요약이나 필요한 발췌만 돌려주게 하고, 도구 스키마를 단순하게 유지합니다. 깊게 중첩된 스키마는 도구 구성과 모델 추론 양쪽에서 토큰을 소비하기 때문입니다. 여기에 적절한 전략의 대화 매니저를 구성하고, 큰 작업은 새 컨텍스트로 처리하는 하위 작업으로 나눕니다.
도구 실행: 검증, 조회, 실행, 결과 반환
모델이 도구를 요청하면 실행 시스템은 네 단계를 차례로 거칩니다. 먼저 요청을 도구 스키마에 맞춰 검증하고, 레지스트리에서 해당 도구를 찾고, 오류 처리로 감싸서 실행한 뒤, 결과를 도구 결과 메시지 형식으로 만듭니다. 모델이 넘기는 인자는 모델이 생성한 출력이므로, 실행 전에 스키마와 맞춰 보는 검증 단계가 있어야 안심하고 도구를 호출할 수 있습니다.
핵심은 실패를 다루는 방식입니다. 실행 시스템은 성공한 결과와 실패를 모두 포착합니다. 도구가 실패하면 루프를 끝내는 예외를 던지지 않고, 오류 정보를 오류 결과로 만들어 모델에 돌려줍니다. 앞의 예제에서 get_order_status가 KeyError를 일으켜도 프로그램이 멈추지 않고, 모델이 그 오류를 읽고 다른 주문 번호로 다시 시도한 이유가 이것입니다. 그래서 도구 안에서 던지는 예외 메시지는 사람보다 모델이 읽는다고 생각하고, 무엇이 잘못되었고 어떻게 고치면 되는지 드러나게 쓰는 편이 좋습니다.
Python SDK에서 이 흐름은 strands.event_loop.event_loop 모듈의 두 함수로 이어집니다. event_loop_cycle은 대화 한 턴을 처리합니다. 사이클 상태와 메트릭을 초기화하고, 실행 한도를 확인하고, 모델로 메시지를 처리하고, 도구 실행 요청을 처리합니다. 주문 조회 예제에 대응시키면, 2번 요청을 받은 사이클이 도구를 실행해 3번 오류 결과를 기록에 붙이고, 처리를 이어 가야 하므로 recurse_event_loop가 현재 상태로 event_loop_cycle을 다시 호출합니다. 이 새 사이클에서 모델이 3번까지 쌓인 기록을 보고 4번 요청을 만들고, 같은 과정이 한 번 더 반복된 뒤 6번에서 도구 요청 없이 끝납니다. 앞서 본 루프 다이어그램의 되돌아가는 화살표가 코드에서는 이 재귀 호출입니다. 사이클의 마지막 이벤트인 EventLoopStopEvent는 종료 이유, 생성된 메시지, 갱신된 메트릭, 요청 상태 등을 묶어 내보냅니다. 입력이 모델이 받기에 너무 크면 이 함수는 ContextWindowOverflowException을 일으키고, 실행 중 다른 오류에는 EventLoopException을 일으킵니다.
다만 오류 결과로 되돌리는 처리는 도구 본문의 실패에만 해당합니다. 수명 주기 훅의 실패, 모델 재시도를 모두 소진한 경우, 잘못된 구성, 그 밖의 SDK 오류는 그대로 애플리케이션까지 전파됩니다. 호출의 결과는 "종료 이유와 함께 돌아온 결과"와 "발생한 예외" 두 갈래이고, 이 둘을 별개로 다뤄야 합니다. 예상치 못한 도구 예외를 모델에 되돌리지 않고 전파하거나 불안정한 도구를 재시도하는 식의 도구 수준 복구는 훅으로 구현하고, 모델 제공자 오류는 재시도 전략이 맡습니다.
종료 이유가 정하는 다음 단계
에이전트가 요청을 받으면 도구를 등록하고 대화 매니저를 준비하고 메트릭 수집을 설정한 뒤, 사용자 입력을 대화 기록의 첫 메시지로 넣고 첫 반복을 시작합니다. 그 뒤로 모델 호출은 매번 종료 이유와 함께 끝나고, 루프는 이 값을 보고 계속할지 멈출지 정합니다. 호출이 끝나면 애플리케이션은 같은 값을 result.stop_reason에서 읽습니다. 종료 이유별 의미와 대응 방법은 다음과 같습니다(괄호 안은 TypeScript SDK의 이름입니다).
| 종료 이유 | 의미 | 루프 동작 | 권장 대응 |
|---|---|---|---|
end_turn (endTurn) |
모델이 응답을 마쳤고 더 할 행동이 없습니다 | 정상 종료하고 최종 메시지를 반환합니다 | 완료된 결과를 반환합니다 |
tool_use (toolUse) |
모델이 도구를 하나 이상 실행하려 합니다 | 도구를 실행하고 결과를 기록에 붙인 뒤 모델을 다시 호출합니다 | 루프 내부에서 처리되므로 대응할 필요가 없습니다 |
stop_sequence (stopSequence) |
설정한 정지 시퀀스를 만났습니다 | end_turn처럼 정상 종료합니다 |
완료된 결과를 반환합니다 |
cancelled |
agent.cancel() 등으로 외부에서 멈췄습니다 |
종료합니다 | 호출자나 애플리케이션이 시작한 중단으로 처리합니다 |
limit_turns (limitTurns) |
호출당 턴 예산을 모두 썼습니다 | 종료하며 기록은 유효한 상태로 남습니다 | 예산 소진을 알리거나 더 큰 한도로 다시 호출합니다 |
limit_total_tokens (limitTotalTokens) |
누적 토큰 예산을 모두 썼습니다 | 종료하며 기록은 유효한 상태로 남습니다 | 예산 소진을 알리거나 더 큰 한도로 다시 호출합니다 |
limit_output_tokens (limitOutputTokens) |
출력 토큰 예산을 모두 썼습니다 | 종료하며 기록은 유효한 상태로 남습니다 | 예산 소진을 알리거나 더 큰 한도로 다시 호출합니다 |
max_tokens (maxTokens) |
모델 응답이 토큰 한도에 걸려 잘렸습니다 | 현재 루프에서 복구할 수 없어 오류로 종료합니다 | 컨텍스트를 줄이거나 한도를 올리거나 작업을 나눕니다 |
content_filtered (contentFiltered) |
안전 메커니즘이 응답을 차단했습니다 | 종료합니다 | 무작정 재시도하지 말고 애플리케이션 정책을 적용합니다 |
guardrail_intervened (guardrailIntervened) |
가드레일 정책이 생성을 멈췄습니다 | 종료합니다 | 무작정 재시도하지 말고 애플리케이션 정책을 적용합니다 |
interrupt |
사람의 입력이 필요해 일시 정지했습니다 | 입력을 받으면 멈춘 지점부터 재개합니다 | 요청된 입력을 받아 에이전트를 재개합니다 |
표에서 눈여겨볼 대비는 세 가지 limit_* 종료 이유와 max_tokens입니다. 이름은 비슷하지만 성격이 정반대입니다. limit_*는 호출 제한에 걸린 정상적인 예산 소진이고 실패가 아닙니다. 메시지 기록이 유효한 상태로 남으므로 같은 에이전트를 더 큰 예산이나 다른 프롬프트로 다시 호출하면 됩니다. 반면 max_tokens는 응답 하나가 제공자의 호출당 출력 한도를 넘어 중간에 잘린 경우입니다. 모델은 잘린 응답에서 이어서 생성하지 못하므로, 루프는 결과를 돌려주지 않고 MaxTokensReachedException을 일으킵니다. 모델이 유난히 긴 응답을 생성하려 할 때, 컨텍스트 윈도우가 거의 차서 응답에 쓸 공간이 부족할 때, 도구 결과가 대화를 토큰 한도 가까이 밀어 올렸을 때 주로 발생합니다. Python SDK는 예외를 일으키기 전에 복구한 부분 메시지를 대화 기록에 추가하므로, 다음 요청을 줄이거나 출력 한도를 올리거나 작업을 잘게 나눈 뒤 같은 에이전트를 다시 호출하면 그 기록에서 이어 갑니다. TypeScript SDK의 MaxTokensError는 partialMessage로 미완성 메시지를 보여 주지만 기록에는 추가하지 않습니다.
cancelled는 기록에 남는 내용이 다릅니다. 취소(cancellation)로 끝나면 조립 중이던 미완성 모델 메시지는 결과와 기록 모두에서 빠집니다. 다만 이미 소비자에게 스트리밍된 조각은 그대로 남아 있으므로, 화면에 부분 응답을 보여 주던 UI라면 이를 따로 정리해야 합니다. 또 취소는 에이전트를 완전히 멈추지만, 인터럽트(interrupt)는 사람의 입력을 기다리며 멈췄다가 그 지점부터 다시 진행합니다.
이 구분을 코드로 옮기면 호출 지점에서 반환된 종료 이유와 발생한 예외를 각각 처리하게 됩니다. 잘린 응답은 try/except에서 잡고, 기록에 남은 부분 메시지를 바탕으로 같은 에이전트에 더 작은 후속 요청을 보냅니다.
from strands import Agent
from strands.types.exceptions import MaxTokensReachedException

agent = Agent(callback_handler=None)

try:
    result = agent("Summarize the quarterly report in three bullet points.")
except MaxTokensReachedException:
    # 부분 메시지가 이미 기록에 들어 있으므로, 같은 에이전트에
    # 더 작은 요청을 보내면 그 기록에서 이어 갑니다.
    result = agent("Continue with only the remaining bullet points, kept short.")

if result.stop_reason in ("end_turn", "stop_sequence"):
    print(str(result))
elif result.stop_reason in ("limit_turns", "limit_total_tokens", "limit_output_tokens"):
    # 기록이 유효하므로 같은 에이전트로 다시 호출할 수 있습니다.
    print("Budget exhausted; consider reinvoking with a higher limit.")
elif result.stop_reason in ("content_filtered", "guardrail_intervened"):
    # 재시도하지 않고 애플리케이션 정책을 적용합니다.
    print("Response blocked by policy.")
elif result.stop_reason == "cancelled":
    # 미완성 메시지는 기록에 없지만, 이미 스트리밍된 조각은 남아 있습니다.
    print("Invocation was cancelled.")
elif result.stop_reason == "interrupt":
    # 사람의 입력이 필요합니다. 에이전트 상태를 보존해 두고,
    # 입력을 받은 뒤 같은 에이전트를 재개해야 합니다.
    print("Waiting for human input.")
후속 호출도 다시 잘릴 수 있으므로, 실제 서비스에서는 몇 번까지 이어 갈지 정해 두고 그 뒤에는 작업을 나누는 쪽으로 넘어가는 편이 안전합니다. 정리하면 잘린 응답은 예외로 받아 기록에서 이어 가고, 정상 종료와 예산 소진, 정책 차단, 취소, 인터럽트는 반환된 종료 이유로 구분해 처리합니다.
도구 연결과 실행 방식
Strands에 붙이는 도구는 크게 세 곳에서 옵니다. 직접 작성한 함수, SDK에 포함된 내장 도구, MCP 서버가 노출하는 도구입니다. 출처가 달라도 에이전트는 모두 같은 도구로 다루고, 모델은 도구 설명을 읽고 언제 호출할지 정합니다. 어떤 도구든 호스트 프로세스의 권한으로 코드를 실행합니다. 따라서 공동 책임 모델에 따라 각 도구의 파일 접근, 네트워크 호출, 셸 실행을 직접 점검하고 배포 환경에 맞는지 판단해야 합니다.
사용자 정의 도구
Python에서 도구를 정의하는 방법은 세 가지입니다. 일반 함수에 @tool 데코레이터를 붙이면 데코레이터가 독스트링과 타입 힌트로 도구 명세를 만듭니다. 상태를 유지해야 하면 클래스 메서드에 @tool을 붙입니다. 도구 명세와 그에 맞는 함수를 담은 Python 모듈로 정의할 수도 있습니다. 이 방식은 도구 정의를 더 세밀하게 제어할 수 있어서, 의존성 없이 도구를 구현할 때 유용합니다. 파일로 만든 도구는 Agent(tools=["/path/to/my_tool.py"])처럼 경로로 불러옵니다.
반환값은 ToolResult로 바뀝니다. 문자열 같은 단순한 값은 {"text": str(result)}로 감싸고, 이미 ToolResult 구조인 딕셔너리는 그대로 쓰고, 예외는 오류 응답이 됩니다. JSON을 넘기거나 오류 상태를 명시하려면 status와 content를 담은 딕셔너리를 직접 반환합니다. content에는 text, json, image, document 블록을 섞을 수 있고, toolUseId는 데코레이터가 채워 줍니다.
사용자 ID처럼 모델이 정하면 안 되고 프롬프트에도 드러나지 않아야 하는 값은 @tool(context=True)로 선언한 뒤 tool_context 매개변수로 받습니다. ToolContext로 호출한 에이전트, 현재 도구 사용 데이터, 호출 상태(invocation_state)에 접근합니다.
from strands import Agent, ToolContext, tool

@tool(context=True)
def lookup_profile(field: str, tool_context: ToolContext) -> dict:
    """Look up one field of the current user's profile.

    Args:
        field: Profile field to return, such as "email" or "plan"
    """
    user_id = tool_context.invocation_state.get("user_id")
    profiles = {"user123": {"email": "user@example.com", "plan": "pro"}}

    if user_id not in profiles or field not in profiles[user_id]:
        return {
            "status": "error",
            "content": [{"text": f"Error: no '{field}' for user {user_id}"}],
        }

    return {
        "status": "success",
        "content": [{"json": {"field": field, "value": profiles[user_id][field]}}],
    }

agent = Agent(tools=[lookup_profile])
agent("What plan am I on?", invocation_state={"user_id": "user123"})
검색어나 파일 경로처럼 모델이 요청에서 추론할 데이터는 도구 매개변수로 넘깁니다. 호출마다 바뀌고 프롬프트에 드러나면 안 되는 문맥은 호출 상태로 넘깁니다. API 키처럼 요청과 무관하게 고정되고 초기화가 필요한 설정은 클래스 기반 도구의 인스턴스로 넘깁니다. 모델은 도구 설명에 크게 의존하므로 독스트링에 목적, 사용 상황, 매개변수와 출력 형식, 제약 사항을 적어 둡니다.
내장 도구
SDK에는 파일 편집, HTTP 요청, 노트북, Bash, MCP Router 등 바로 쓸 수 있는 내장 도구(vended tools)가 들어 있고 strands.vended_tools에서 가져옵니다. http_request는 네트워크 작업을 httpx.AsyncClient에 맡기므로, 인증 헤더나 프록시가 필요하면 make_http_request에 미리 구성한 클라이언트를 넘깁니다. 붙인 도구는 모두 agent.tool 아래 메서드가 되어 모델을 거치지 않고 코드에서 바로 부를 수 있습니다.
import httpx
from strands import Agent
from strands.vended_tools import make_http_request, notebook

client = httpx.AsyncClient(headers={"Authorization": "Bearer token"})
agent = Agent(tools=[make_http_request(client=client), notebook])

# 설명과 입력 매개변수까지 보려면 agent.tool_registry.get_all_tools_config()를 씁니다.
print(agent.tool_names)

# 직접 호출에는 키워드 인자만 씁니다. 위치 인자는 오류를 일으킵니다.
# 이름에 하이픈이 있으면 밑줄로 바꿔 부릅니다("read-all" → agent.tool.read_all).
agent.tool.notebook(mode="read", name="ideas")
파일 편집기는 임의의 절대 경로를 프로세스 권한으로 읽고 쓰므로 신뢰할 수 있는 입력에만 쓰고, 프로덕션에서는 샌드박스 실행을 검토합니다.
MCP 도구
데이터베이스, SaaS API, 사내 서비스처럼 코드베이스 밖의 도구는 MCP 서버로 연결합니다. 로컬 프로세스에는 stdio를, OAuth나 AWS IAM 인증이 걸린 서버를 포함한 원격 HTTP 서버에는 Streamable HTTP를, 예전 SSE 방식 서버에는 SSE 전송을 씁니다. 연결 코드는 같고 클라이언트에 넘기는 전송 객체만 바뀝니다.
from mcp import stdio_client, StdioServerParameters
from mcp.client.sse import sse_client
from strands import Agent
from strands.tools.mcp import MCPClient

sse_mcp_client = MCPClient(lambda: sse_client("http://localhost:8000/sse"))
stdio_mcp_client = MCPClient(lambda: stdio_client(
    StdioServerParameters(command="python", args=["path/to/mcp_server.py"])
))

# 아래 두 방식 중 하나를 고릅니다.

# 수동 방식: 컨텍스트 매니저 안에서 도구 목록을 직접 가져옵니다.
with sse_mcp_client, stdio_mcp_client:
    tools = sse_mcp_client.list_tools_sync() + stdio_mcp_client.list_tools_sync()
    agent = Agent(tools=tools)

# 관리형 방식: 클라이언트를 그대로 넘기면 에이전트가 연결을 관리합니다.
agent = Agent(tools=[sse_mcp_client, stdio_mcp_client])
서버가 여러 개라면 MCPClient.load_servers로 구성 딕셔너리나 JSON 파일에서 클라이언트를 한꺼번에 만들고, 도구 이름이 겹치면 prefix_with_server_name=True를 씁니다.
연결할 서버를 모델이 실행 중에 고르게 하려면 make_mcp_router에 서버 허용 목록을 넘깁니다. 모델은 목록 안의 서버에만 연결하고, 도구 목록을 조회하고, 도구를 호출하고, 연결을 닫는 일까지 직접 합니다. 허용한 stdio 명령은 호스트의 파일 시스템, 환경 변수, 네트워크에 접근하는 로컬 프로세스로 실행되므로 호스트에서 직접 실행해도 괜찮은 명령만 넣습니다.
동시 실행기와 순차 실행기
모델이 응답 하나에서 도구를 여러 개 요청하면, 이를 한꺼번에 실행할지 차례로 실행할지는 도구 실행기(tool executor)가 정합니다. Python과 TypeScript SDK 모두 기본값은 동시 실행입니다.
from strands import Agent
from strands.tools.executors import ConcurrentToolExecutor, SequentialToolExecutor

# 기본값과 같습니다. Agent(tools=[weather_tool, time_tool])로 써도 됩니다.
parallel_agent = Agent(
    tool_executor=ConcurrentToolExecutor(),
    tools=[weather_tool, time_tool],
)

# 이메일이 앞 단계에서 만든 스크린샷에 의존하므로 순서를 보장합니다.
ordered_agent = Agent(
    tool_executor=SequentialToolExecutor(),
    tools=[screenshot_tool, email_tool],
)
ordered_agent("Please take a screenshot and then email the screenshot to my friend")
| 구분 | 동시 실행기 | 순차 실행기 |
|---|---|---|
| 실행 방식 | 한 턴의 도구 호출을 병렬로 실행합니다 | 모델이 준 순서대로 하나씩 실행합니다 |
| 지연 시간 | 가장 느린 도구에 맞춰집니다 | 모든 도구 실행 시간의 합입니다 |
| 적합한 경우 | 서로 독립적인 조회가 여럿일 때입니다 | 뒤 도구가 앞 도구의 부수 효과에 의존할 때입니다 |
| 이벤트 순서 | 도구별 순서는 지키지만 도구끼리는 섞일 수 있습니다 | 도구 단위로 차례대로 나옵니다 |
| 실행 중 취소 | 모두 이미 시작했으므로 각 도구가 스스로 취소를 확인해야 멈춥니다 | 아직 시작하지 않은 도구는 건너뜁니다 |
동시 실행기라도 병렬 실행은 모델이 응답 하나에 도구 요청을 여러 개 담았을 때만 일어나고, 요청을 하나씩 보내면 차례로 실행됩니다. Anthropic처럼 병렬 도구 사용 설정을 제공하는 모델은 이 동작에 영향을 줄 수 있습니다.
도구 하나의 이벤트는 어느 모드에서나 BeforeToolCallEvent → ToolStreamEvent* → AfterToolCallEvent → ToolResultEvent 순서입니다. 동시 모드에서는 여러 도구의 이벤트가 섞여 나올 수 있으므로 소비하는 쪽에서 도구별로 구분해 처리해야 합니다. 두 실행기 외에 직접 만든 실행기는 아직 지원하지 않습니다.
모델 제공자 구성: Amazon Bedrock을 중심으로
Agent()를 모델 없이 만들면 내부에서 BedrockModel이 생성됩니다. Amazon Bedrock은 여러 회사의 파운데이션 모델을 AWS API 하나로 제공합니다. BedrockModel은 텍스트 생성, 멀티모달 입력, 도구 호출, 가드레일, 그리고 시스템 프롬프트·도구·메시지를 캐시하는 프롬프트 캐싱(prompt caching)을 지원합니다. 기본 제공자를 그대로 쓰더라도 자격 증명, 리전, 모델 ID, 캐싱, 스트리밍 방식은 직접 정해 두어야 운영 환경에서 동작을 예측할 수 있습니다.
자격 증명과 IAM 권한
호출하는 IAM 사용자나 역할에는 두 권한이 필요합니다. 스트리밍 모드에는 bedrock:InvokeModelWithResponseStream이, 비스트리밍 모드에는 bedrock:InvokeModel이 필요합니다. 개발 단계에서는 다음 정책으로 시작하고, 프로덕션에서는 Resource를 실제로 쓰는 모델 ARN으로 좁힙니다.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": [
        "bedrock:InvokeModelWithResponseStream",
        "bedrock:InvokeModel"
      ],
      "Resource": "*"
    }
  ]
}
Python SDK는 boto3로 Bedrock을 호출하므로 자격 증명도 boto3 탐색 규칙을 따릅니다. 개발 환경에서는 aws configure, 환경 변수, 직접 만든 boto3 세션, aws login 가운데 하나를 고르면 됩니다. 브라우저로 임시 자격 증명을 받는 aws login에는 AWS CLI 2.32.0 이상이 필요합니다. SigV4 서명 대신 Bedrock API 키로 베어러 토큰 인증을 하려면 api_key를 넘깁니다.
리전은 자주 혼동되는 부분입니다. boto3 동작 방식 때문에 리전은 아래 순서로 정해집니다.
BedrockModel(region_name="...")에 직접 넘긴 리전- boto3 세션의 리전(
AWS_DEFAULT_REGION또는~/.aws/config프로필의 리전) AWS_REGION환경 변수- 기본 리전
us-west-2
AWS_REGION이 프로필 리전보다 순위가 낮아서, 환경 변수를 바꿨는데도 다른 리전으로 요청이 가는 일이 생깁니다. 리전이 예상과 다르면 AWS 설정 파일을 확인하고, AWS_DEFAULT_REGION을 쓰거나 생성자에 region_name을 명시합니다.
모델 선택과 설정
모델만 바꿀 때는 Agent(model="global.anthropic.claude-sonnet-5")처럼 모델 ID 문자열을 바로 넘겨도 됩니다. 샘플링 매개변수나 자격 증명까지 제어하려면 BedrockModel 인스턴스를 만듭니다. 자주 쓰는 옵션은 model_id, temperature, max_tokens, streaming, guardrail_id, cache_config, strict_tools, boto_session, api_key, additional_request_fields이고, 모델별 고유 매개변수는 additional_request_fields로 전달합니다. strict_tools를 켜면 oneOf처럼 엄격 모드가 지원하지 않는 스키마는 요청 시점에 실패합니다.
import boto3
from strands import Agent
from strands.models import BedrockModel

session = boto3.Session(
    region_name="us-west-2",
    profile_name="your-profile",  # 선택: 특정 프로필 사용
)

bedrock_model = BedrockModel(
    model_id="us.amazon.nova-premier-v1:0",
    boto_session=session,
    temperature=0.3,
    top_p=0.8,
)

agent = Agent(model=bedrock_model)
agent("Tell me about Amazon Bedrock.")

# 실행 중에도 설정을 바꿀 수 있습니다. 도구가 모델 구성을 바꿔야 할 때는
# 도구 안에서 agent.model.update_config(model_id=...)처럼 호출합니다.
bedrock_model.update_config(temperature=0.7)
프롬프트 캐싱
에이전트 루프는 반복할 때마다 같은 시스템 프롬프트와 도구 정의, 계속 늘어나는 대화 기록을 모델에 다시 보냅니다. 프롬프트 캐싱을 쓰면 Bedrock이 반복되는 앞부분을 다시 처리하지 않고 재사용하므로 토큰 사용량과 지연 시간이 줄어듭니다. Bedrock은 캐시 지점(cache point)이라는 표식으로 캐시할 연속 구간을 정하고, 캐시된 내용이 조금이라도 바뀌면 캐시를 무효화합니다. Bedrock의 Anthropic Claude와 Amazon Nova 모델이 지원합니다. 모델마다 최소 토큰 수가 있고(Claude Sonnet은 1,024, Claude Haiku는 4,096), 5분 동안 쓰지 않으면 만료됩니다. 캐시 쓰기는 일반 입력 토큰보다 비싸고 캐시 읽기는 훨씬 싸므로, 같은 앞부분을 여러 번 읽어야 이득입니다.
가장 간단한 방법은 CacheConfig(strategy="auto")입니다. 이 전략은 매 요청마다 시스템 프롬프트 끝에 캐시 지점을 붙이고, 마지막 사용자 메시지 끝에도 캐시 지점을 두어 다중 턴 대화에서 누적된 문맥을 재사용합니다. 메시지 자동 배치는 Claude 모델에서만 동작합니다. 도구 정의는 tools_ttl로 캐시하는데, True는 제공자 기본 TTL을, "1h" 같은 문자열은 그 기간을 뜻합니다. cache_prompt와 cache_tools는 지원 중단되었으므로 새 코드에서는 cache_config를 씁니다.
from strands import Agent
from strands.models import BedrockModel, CacheConfig

model = BedrockModel(
    model_id="global.anthropic.claude-sonnet-5",
    cache_config=CacheConfig(strategy="auto"),
)
agent = Agent(model=model, system_prompt="You are a helpful assistant...")

first = agent("Search for Python async patterns, then compare with error handling")
second = agent("Summarize the key differences")

for label, result in (("first", first), ("second", second)):
    usage = result.metrics.accumulated_usage
    print(label, usage.get("cacheWriteInputTokens"), usage.get("cacheReadInputTokens"))
캐시 지점 위치가 효과를 좌우합니다. 검색 결과나 타임스탬프처럼 호출마다 바뀌는 내용이 캐시 지점 앞에 있으면 매 요청이 새 항목을 쓰기만 하고 읽지는 못합니다. 시스템 프롬프트가 요청마다 바뀐다면 system_prompt_ttl=False로 자동 시스템 캐시 지점만 끕니다. 도구와 메시지 캐싱은 그대로 유지됩니다. TTL은 도구 정의, 시스템 프롬프트, 메시지 순으로 늘어나면 안 되고, 짧은 TTL 뒤에 긴 TTL이 오면 Bedrock이 요청을 거부합니다. 대화 매니저의 요약이나 과거 메시지 편집처럼 지난 대화를 바꾸는 작업도 캐시 미스를 일으킵니다.
model_id에 애플리케이션 추론 프로파일 ARN을 넣으면 auto 전략이 캐싱을 건너뜁니다. auto는 모델 ID에서 "claude"나 "anthropic" 문자열을 찾는데, 이 ARN에는 모델 이름이 없기 때문입니다. 이때는 CacheConfig(strategy="anthropic")을 명시합니다. 성능은 auto와 같고 추가 API 호출이나 IAM 권한이 필요 없습니다.
스트리밍과 비스트리밍 모드
BedrockModel은 기본적으로 스트리밍(streaming=True)으로 호출합니다. 일부 Bedrock 모델은 도구 사용을 비스트리밍으로만 지원하므로, 그런 모델에는 streaming=False를 지정합니다.
from strands.models import BedrockModel

non_streaming_model = BedrockModel(
    model_id="us.meta.llama3-2-90b-instruct-v1:0",
    streaming=False,
)
Strands가 비스트리밍 응답을 내부에서 스트리밍 형식으로 변환하므로, 어느 모드든 에이전트가 내보내는 이벤트 구조와 동작은 같습니다. 모드를 바꿔도 이벤트를 소비하는 코드는 고칠 필요가 없지만, 필요한 IAM 권한은 모드마다 다릅니다. 모델별 스트리밍 지원 여부는 Bedrock 문서의 모델 기능 표에서 확인합니다.
이벤트 스트리밍과 결과 객체
에이전트가 한 번 응답하는 동안 모델 호출과 도구 실행이 여러 차례 일어납니다. 최종 답만 기다리면 그사이 화면이 멈춘 것처럼 보이고, 어디서 실패했는지도 알기 어렵습니다. Strands는 루프가 진행되는 동안 이벤트를 흘려보내고, 호출이 끝나면 실행 전체를 담은 AgentResult를 돌려줍니다. 사용자 경험은 이벤트로 만들고, 결과 처리와 사후 분석은 결과 객체로 합니다.
모델 스트림 이벤트의 구성
모델이 내보내는 출력 스트림의 타입은 strands.types.streaming의 StreamEvent입니다. 이 타입은 Bedrock API를 본떠 정의되어 있고, 이벤트 하나는 아래 키 가운데 하나를 담은 딕셔너리입니다.
| 키 | 담기는 내용 |
|---|---|
messageStart |
메시지 시작과 발신자 역할(role) |
contentBlockStart |
콘텐츠 블록 시작 정보와 블록 인덱스 |
contentBlockDelta |
블록에 덧붙는 조각(텍스트, 도구 입력, 추론) |
contentBlockStop |
콘텐츠 블록 종료 |
messageStop |
메시지 종료와 종료 이유(stopReason), 추가 응답 필드 |
metadata |
모델 호출의 사용량(usage), 성능 메트릭(metrics), 트레이스(trace) |
modelStreamErrorException |
스트리밍 오류와 제공자의 원본 메시지, HTTP 상태 코드 |
throttlingException, serviceUnavailableException, internalServerException, validationException |
각 유형의 오류 정보 |
메시지는 messageStart로 열리고 messageStop으로 닫히며, 그 사이에 콘텐츠 블록마다 시작·델타·종료가 이어집니다. 실제 내용은 contentBlockDelta 안의 delta에 실려 옵니다. text는 사용자에게 바로 보여 줄 텍스트 조각입니다. toolUse는 도구 입력의 일부(input)여서 블록이 끝날 때까지 이어 붙여야 완전한 입력이 됩니다. 제공자에 따라 toolUseId와 name이 contentBlockStart가 아니라 델타에 실려 오기도 하므로 두 위치를 모두 확인해야 안전합니다. reasoningContent에는 모델의 추론 텍스트(text)와, 그 텍스트를 모델이 생성했음을 검증하는 signature, 제공자가 안전상 암호화한 redactedContent가 들어갑니다.
인용 정보는 별도 타입으로 정의된 CitationsDelta로 조금씩 채워집니다. 출처 문서 안의 위치(location), 인용된 내용(sourceContent), 문서 제목(title)이 응답 생성에 맞춰 차례로 쌓입니다. metadata.trace는 디버깅과 모니터링을 위한 정보입니다.
contentBlockIndex는 제공자마다 다르게 다루므로 선택 필드입니다. 블록을 인덱스로만 구분하는 코드는 일부 제공자에서 깨질 수 있습니다. 이 밖에 사용자 입력이나 어시스턴트 출력을 지정한 문자열로 덮어쓰라는 RedactContentEvent(redactUserContentMessage, redactAssistantContentMessage)도 있습니다. UI라면 이미 표시한 내용을 이 이벤트가 지정한 문자열로 바꿔 그리도록 처리해 둡니다.
기본 콘솔 콜백 핸들러와 stream_async
이벤트를 UI로 보내는 방법은 비동기 이터레이터와 콜백 핸들러 두 가지입니다. 별다른 설정이 없으면 에이전트는 응답을 콘솔에 스트리밍하고, Agent(callback_handler=None)으로 만들면 이 출력이 꺼집니다. 동기 호출로 응답을 바로 지켜볼 때는 기본 동작으로 충분하고, 비동기 웹 서버처럼 이벤트를 코드에서 직접 다뤄야 할 때는 콘솔 출력을 끄고 agent.stream_async()를 async for로 돕니다.
도구도 스트림에 참여합니다. 비동기 도구가 yield한 값은 각각 스트리밍 이벤트가 되고, 마지막 값이 도구의 반환 결과가 됩니다. 이벤트는 tool_stream_event 딕셔너리로 들어오며, tool_use에는 호출 정보가, data에는 도구가 내보낸 값이 담깁니다.
import asyncio
from datetime import datetime
from strands import Agent, tool

@tool
async def process_dataset(records: int) -> str:
    """Process records with progress updates."""
    start = datetime.now()

    for i in range(records):
        await asyncio.sleep(0.1)
        if i % 10 == 0:
            elapsed = datetime.now() - start
            yield f"Processed {i}/{records} records in {elapsed.total_seconds():.1f}s"

    yield f"Completed {records} records in {(datetime.now() - start).total_seconds():.1f}s"

async def tool_stream_example():
    agent = Agent(tools=[process_dataset], callback_handler=None)

    async for event in agent.stream_async("Process 50 records"):
        if tool_stream := event.get("tool_stream_event"):
            tool_use_id = tool_stream.get("tool_use", {}).get("toolUseId")
            if update := tool_stream.get("data"):
                print(f"[{tool_use_id}] Progress: {update}")

asyncio.run(tool_stream_example())
Strands는 비동기 도구를 모두 동시에 실행하므로 도구 이벤트가 섞여 들어올 수 있습니다. 진행률은 toolUseId로 묶어 갱신합니다. TypeScript SDK에서는 agent.stream()을 for await로 돌고, event.type === 'toolStreamUpdateEvent'인 이벤트의 event.event.data로 같은 값을 받습니다.
AgentResult: 메시지, 메트릭, 트레이스
호출이 끝나면 AgentResult가 반환됩니다. 결과 객체에는 실행 중에 생긴 메시지, 메트릭, 트레이스가 담겨 있어서, 에이전트가 어떤 도구를 왜 호출했는지 나중에 확인할 수 있습니다. 모델 호출마다 metadata 이벤트로도 사용량과 메트릭이 옵니다.
from strands import Agent

agent = Agent(callback_handler=None)
result = agent("Explain the difference between a process and a thread.")

print(result.stop_reason)      # 루프가 끝난 이유
print(result.message)          # 마지막 어시스턴트 메시지
print(result.metrics.get_summary())  # 사이클 수, 누적 토큰, 도구별 사용량
HTTP 응답으로 돌려줄 때는 {"output": result.message}처럼 마지막 메시지만 담습니다. 스트림 이벤트는 화면에 그리고 나면 지나가므로, 기록으로 남길 값은 호출이 끝난 뒤 결과 객체에서 읽어 저장하는 편이 안전합니다.
훅으로 루프 확장하기
에이전트 루프에 로깅, 검증, 가드레일을 넣고 싶을 때 도구 본문이나 루프 코드를 직접 고치면 관심사가 섞이고 재사용도 어렵습니다. 훅(hook)은 이 문제를 이벤트 구독으로 풉니다. 훅 이벤트는 수명 주기의 한 지점이고, 훅 콜백은 그 이벤트가 발생할 때 실행되도록 등록한 함수입니다. 콜백은 이벤트마다 타입이 지정된 이벤트 객체를 받습니다. BeforeInvocationEvent에는 에이전트와 요청 정보가, BeforeToolCallEvent에는 호출될 도구와 매개변수가 담깁니다. 이벤트 타입 하나에 구독자를 여러 개 붙일 수 있고, SDK의 내장 구성 요소도 같은 메커니즘으로 루프에 참여합니다. 사용자 코드와 SDK 코드가 같은 이벤트를 나눠 듣는 구조여서, 콜백이 실행되는 순서가 중요해집니다.
훅 이벤트의 수명 주기
도구를 쓰는 일반적인 호출 하나에서 Python SDK가 내보내는 이벤트는 다음 순서를 따릅니다.
BeforeInvocationEvent: 새 호출 요청이 시작될 때 발생합니다.MessageAddedEvent: 사용자 입력이 대화 기록에 추가될 때 발생합니다. 메시지가 기록에 들어갈 때마다 다시 발생합니다.BeforeModelCallEvent→AfterModelCallEvent: 모델 추론 앞뒤에서 발생하고, 이어서 어시스턴트 메시지에 대한MessageAddedEvent가 발생합니다.- 모델이 도구를 요청했다면
BeforeToolsEvent가 배치 전체에 한 번 발생하고, 도구마다BeforeToolCallEvent와AfterToolCallEvent가 발생한 뒤AfterToolsEvent로 배치가 닫힙니다. 도구 결과 메시지가 기록에 들어가면 다시 모델 호출로 돌아갑니다. - 도구 요청이 없으면 루프가 끝나고
AfterInvocationEvent가 발생합니다. 이 이벤트는 호출이 성공하든 실패하든 발생합니다.
이 밖에 에이전트 생성자가 초기화를 마친 시점에 AgentInitializedEvent가 한 번 발생합니다. Graph나 Swarm 같은 오케스트레이터에는 BeforeNodeCallEvent, AfterNodeCallEvent 같은 노드 단위 이벤트가 따로 있고, 오케스트레이터 안의 개별 에이전트도 자기 훅을 그대로 유지하므로 두 층위의 훅을 겹쳐 쓸 수 있습니다.
이벤트 속성은 대부분 읽기 전용입니다. 의도하지 않은 변경을 막으려는 설계이고, 루프의 동작을 바꾸는 통로는 아래 속성으로 제한됩니다.
| 이벤트 | 수정 가능한 속성 | 효과 |
|---|---|---|
BeforeToolsEvent |
cancel |
배치의 모든 도구 호출을 메시지와 함께 취소 |
BeforeToolCallEvent |
tool_use |
실행 전 도구 매개변수 변경 |
BeforeToolCallEvent |
selected_tool |
실행할 도구 자체를 교체 |
BeforeToolCallEvent |
cancel_tool |
메시지와 함께 해당 도구 실행 취소 |
AfterModelCallEvent |
retry |
모델 호출 재시도 요청 |
AfterToolCallEvent |
result |
모델에 전달될 도구 결과 변경 |
AfterToolCallEvent |
retry |
도구 호출 재시도 요청 |
AfterToolsEvent |
end_turn |
모델을 다시 부르지 않고 루프 종료 |
AfterInvocationEvent |
resume |
새 입력으로 후속 호출 시작 |
AfterToolCallEvent.exception도 읽을 수 있지만 읽기 전용입니다. 등록 방법은 세 가지입니다. 콜백 하나는 agent.add_hook()으로 붙이고, 타입 힌트가 있으면 이벤트 타입을 따로 지정하지 않아도 추론됩니다. 콜백 여러 개를 묶을 때는 register_hooks(registry)를 구현한 HookProvider를 Agent(hooks=[...])로 넘기거나, 설정과 도구까지 함께 묶을 수 있는 플러그인을 Agent(plugins=[...])로 넘깁니다. 대부분은 플러그인 쪽이 편리합니다. 콜백 안에서는 event.invocation_state로 호출할 때 넘긴 세션 ID나 데이터베이스 연결 같은 문맥을 읽을 수 있습니다.
콜백 순서
같은 이벤트에 콜백이 여럿이면 순서가 결과를 바꿉니다. 인자를 고정하는 훅과 인자를 검증하는 훅이 있다면, 검증이 먼저 돌면 고정되기 전 값을 보게 됩니다. Strands의 기본 규칙은 이렇습니다. Before 이벤트는 등록 순서대로 실행되고, After 이벤트(AfterInvocationEvent, AfterModelCallEvent, AfterToolCallEvent, AfterToolsEvent 등)는 등록 역순으로 실행됩니다. 중첩된 컨텍스트 매니저처럼 먼저 연 쪽이 나중에 닫히게 해서, 타이머를 시작하고 멈추거나 리소스를 잡고 놓는 쌍이 대칭을 이루게 하려는 설계입니다.
기본 순서로 부족하면 order 옵션으로 우선순위를 직접 줍니다. 값이 작을수록 먼저 실행됩니다. SDK는 자기 훅이 실행되는 위치를 표시한 프리셋을 제공합니다. HookOrder.SDK_FIRST(-100)는 SDK의 가장 이른 훅이, HookOrder.DEFAULT(0)는 순서를 지정하지 않은 훅이, HookOrder.SDK_LAST(100)는 SDK의 가장 늦은 훅이 실행되는 위치입니다. 이 값들은 경계가 아니어서 어떤 숫자든 쓸 수 있습니다. SDK 훅보다 확실히 먼저 돌아야 하는 가드레일은 HookOrder.SDK_FIRST - 1처럼 프리셋 바깥 값을 주고, 절대적인 처음과 끝이 필요하면 float('-inf')와 float('inf')를 씁니다. 같은 순서 그룹 안에서는 다시 기본 규칙이 적용되어 Before는 등록 순서를, After는 역순을 따릅니다.
from strands import Agent
from strands.hooks import AfterToolCallEvent, BeforeToolCallEvent, HookOrder

agent = Agent()

def audit_start(event: BeforeToolCallEvent) -> None:
    print(f"[audit] start {event.tool_use['name']}")

def metrics_start(event: BeforeToolCallEvent) -> None:
    print(f"[metrics] start {event.tool_use['name']}")

def guardrail(event: BeforeToolCallEvent) -> None:
    print("[guardrail] runs before the SDK's earliest hooks")

def audit_end(event: AfterToolCallEvent) -> None:
    print(f"[audit] end {event.tool_use['name']}")

def metrics_end(event: AfterToolCallEvent) -> None:
    print(f"[metrics] end {event.tool_use['name']}")

# 이벤트 타입은 타입 힌트에서 추론됩니다.
agent.add_hook(audit_start)
agent.add_hook(metrics_start)
agent.add_hook(guardrail, order=HookOrder.SDK_FIRST - 1)
agent.add_hook(audit_end)
agent.add_hook(metrics_end)
예시(설명용으로 손으로 따라간 실행): 위 에이전트에 도구가 등록되어 있고 도구가 한 번 호출된다고 가정하고 규칙만으로 순서를 따라가 봅니다. BeforeToolCallEvent에서는 순서 값이 가장 작은 guardrail이 SDK 훅보다도 먼저 돌고, 기본 그룹의 audit_start와 metrics_start가 등록 순서대로 이어집니다. AfterToolCallEvent에서는 기본 그룹이 역순으로 돌아 metrics_end가 먼저, audit_end가 나중에 실행됩니다. 감사 로그는 가장 바깥에서 도구 실행을 감싸고 메트릭은 그 안쪽을 감싸는 모양이 되어, 시작과 끝의 짝이 엇갈리지 않습니다.
도구 가로채기
BeforeToolCallEvent는 모델이 고른 도구와 인자가 실제로 실행되기 직전의 관문입니다. 모델의 결정을 시스템 정책으로 덮어써야 하는 경우가 여기에 해당합니다. 모델이 무엇을 요청하든 특정 매개변수를 고정하려면 tool_use["input"]을 고치고, 위험한 도구를 안전한 대안으로 바꾸려면 selected_tool에 다른 도구를 넣습니다. 도구를 교체할 때는 tool_use["name"]도 함께 바꿔서 모델이 대체 사실을 볼 수 있게 합니다. 실행 자체를 막으려면 cancel_tool에 메시지를 넣습니다. 그러면 도구는 실행되지 않고 그 메시지로 대체됩니다. 배치 전체를 한 번에 막을 때는 BeforeToolsEvent.cancel을 씁니다.
아래 정책 훅은 인자 고정과 호출 횟수 제한을 함께 처리합니다. 횟수는 BeforeInvocationEvent에서 매 호출마다 초기화하고, 카운터는 잠금으로 보호합니다.
from threading import Lock
from typing import Any

from strands.hooks import BeforeInvocationEvent, BeforeToolCallEvent, HookProvider, HookRegistry


class ToolPolicy(HookProvider):
    """Force fixed arguments and cap call counts per invocation."""

    def __init__(self, fixed_arguments: dict[str, dict[str, Any]], max_calls: dict[str, int]):
        self.fixed_arguments = fixed_arguments
        self.max_calls = max_calls
        self.counts: dict[str, int] = {}
        self._lock = Lock()

    def register_hooks(self, registry: HookRegistry, **kwargs: Any) -> None:
        registry.add_callback(BeforeInvocationEvent, self.reset_counts)
        registry.add_callback(BeforeToolCallEvent, self.apply_policy)

    def reset_counts(self, event: BeforeInvocationEvent) -> None:
        with self._lock:
            self.counts = {}

    def apply_policy(self, event: BeforeToolCallEvent) -> None:
        name = event.tool_use["name"]

        with self._lock:
            count = self.counts.get(name, 0) + 1
            self.counts[name] = count

        limit = self.max_calls.get(name)
        if limit and count > limit:
            event.cancel_tool = (
                f"Tool '{name}' has been invoked too many times and is now being throttled. "
                f"DO NOT CALL THIS TOOL ANYMORE"
            )
            return

        if fixed := self.fixed_arguments.get(name):
            event.tool_use["input"].update(fixed)
Agent(tools=[calculator, sleep], hooks=[ToolPolicy({"calculator": {"precision": 1}}, {"sleep": 3})])처럼 붙이면, 모델이 precision을 어떻게 지정하든 1로 실행되고 sleep은 호출 한 번에 세 번까지만 실행됩니다.
결과 수정과 예외 전파
AfterToolCallEvent는 반대편 관문입니다. 도구가 돌려준 result는 모델에 전달되기 전에 여기서 고칠 수 있어서, 출력 형식을 맞추는 데 씁니다. 결과를 고칠 때는 원래 값과 바뀐 값을 함께 로그로 남겨 두어야 디버깅과 감사가 가능합니다.
같은 이벤트의 exception은 도구 예외 처리의 빈틈을 메웁니다. 도구가 예외를 던지면 에이전트는 이를 오류 결과로 바꿔 모델에 돌려주고, 모델은 접근을 바꿔 다시 시도합니다. 입력 검증 실패처럼 예상한 오류라면 바람직하지만, 설정 오류나 버그라면 모델이 같은 실패를 헛되이 반복할 뿐입니다. 훅에서 exception의 타입을 확인하고 예상하지 못한 예외만 다시 던지면 호출이 즉시 실패합니다. 이 기능은 아직 TypeScript SDK에서 지원하지 않습니다.
import logging

from strands.hooks import AfterToolCallEvent, HookProvider, HookRegistry

logger = logging.getLogger(__name__)


class ToolResultGuard(HookProvider):
    """Format calculator output and fail fast on unexpected tool errors."""

    def __init__(self, allowed_exceptions: tuple[type[Exception], ...] = (ValueError,)):
        self.allowed_exceptions = allowed_exceptions

    def register_hooks(self, registry: HookRegistry) -> None:
        registry.add_callback(AfterToolCallEvent, self.check_exception)
        registry.add_callback(AfterToolCallEvent, self.format_result)

    def check_exception(self, event: AfterToolCallEvent) -> None:
        if event.exception is None:
            return  # 도구가 성공했습니다.
        if isinstance(event.exception, self.allowed_exceptions):
            return  # 모델이 다시 시도하도록 오류 결과를 그대로 둡니다.
        raise event.exception  # 예상하지 못한 오류는 호출 밖으로 전파합니다.

    def format_result(self, event: AfterToolCallEvent) -> None:
        if event.tool_use["name"] == "calculator" and event.exception is None:
            original = event.result["content"][0]["text"]
            logger.info(f"Modifying calculator result: {original}")
            event.result["content"][0]["text"] = f"Result: {original}"
After 이벤트는 역순으로 실행되므로, 이 클래스에서는 나중에 등록한 format_result가 먼저 돌고 check_exception이 마지막에 돕니다. 그래서 format_result에서도 exception을 확인해, 예외 확인보다 먼저 돌더라도 오류 결과를 고치지 않게 했습니다. 배치 단위로 판단해야 한다면 AfterToolsEvent.end_turn을 씁니다. True를 넣으면 기본 최종 메시지로, 문자열이나 콘텐츠 블록 목록을 넣으면 그 내용을 최종 어시스턴트 메시지로 삼아 모델을 다시 부르지 않고 루프를 끝내며, 반환되는 결과의 종료 이유는 end_turn입니다.
호출 재개(resume)
지금까지의 훅은 한 호출 안에서 루프를 바꿨습니다. AfterInvocationEvent.resume은 호출이 끝난 뒤를 다룹니다. 이 속성에 유효한 에이전트 입력(문자열, 콘텐츠 블록 목록, 메시지 목록, 인터럽트 응답)을 넣으면, 에이전트는 호출자에게 돌아가지 않고 그 입력으로 자신을 다시 호출합니다. 호출자 입장에서는 agent(...) 한 번이지만 내부에서는 결과를 평가하고 추가 지시를 넣고 다시 실행하는 다단계 흐름이 돕니다. TypeScript SDK에서는 이 재진입이 같은 호출 잠금 아래에서 일어납니다.
재개는 완전히 새로운 호출 사이클이어서 BeforeInvocationEvent부터 다시 발생합니다. 앞서 만든 ToolPolicy처럼 BeforeInvocationEvent에서 상태를 초기화하는 훅은 재개할 때마다 카운터가 다시 0이 됩니다. 반대로 재개 횟수를 세는 카운터는 같은 이유로 BeforeInvocationEvent에서 초기화할 수 없습니다. 그렇게 하면 종료 조건이 매번 풀려 무한 루프가 됩니다.
핵심:
resume은BeforeInvocationEvent를 다시 발생시키므로, "호출마다" 초기화하는 상태와 "호출자 요청마다" 유지할 상태를 구분해야 합니다. 재개 횟수 같은 종료 조건은 호출자가 요청 단위로 초기화합니다.
from strands import Agent
from strands.hooks import AfterInvocationEvent


class RefineLoop:
    """Re-invoke the agent a bounded number of times to refine its answer."""

    def __init__(self, max_iterations: int = 3):
        self.max_iterations = max_iterations
        self.iteration = 0

    def start_request(self) -> None:
        # 재개도 BeforeInvocationEvent를 발생시키므로, 카운터는 호출자가 초기화합니다.
        self.iteration = 0

    async def __call__(self, event: AfterInvocationEvent) -> None:
        if self.iteration >= self.max_iterations or not event.result:
            return
        if event.result.stop_reason != "end_turn":
            return  # 인터럽트나 제한으로 끝났다면 재개하지 않습니다.
        self.iteration += 1
        event.resume = (
            f"Review your previous response and improve it. "
            f"Iteration {self.iteration} of {self.max_iterations}."
        )


refine = RefineLoop(max_iterations=3)
agent = Agent()
agent.add_hook(refine, AfterInvocationEvent)

refine.start_request()
result = agent("Draft a haiku about programming")
인터럽트와 함께 쓸 때는 규칙이 하나 더 붙습니다. 호출이 인터럽트로 끝나 에이전트가 인터럽트 상태이면 resume에는 interruptResponse 객체 목록을 넣어야 하고, 일반 문자열을 넣으면 TypeError가 발생합니다. 아래 예는 BeforeToolCallEvent에서 이메일 전송 전에 인터럽트를 걸고, AfterInvocationEvent에서 승인 응답으로 재개합니다. 호출자는 인터럽트를 보지 않고 최종 결과를 바로 받습니다.
from strands import Agent, tool
from strands.hooks import AfterInvocationEvent, BeforeToolCallEvent


@tool
def send_email(to: str, body: str) -> str:
    """Send an email.

    Args:
        to: Recipient address.
        body: Email body.
    """
    return f"Email sent to {to}"


def require_approval(event: BeforeToolCallEvent):
    if event.tool_use["name"] == "send_email":
        event.interrupt("email_approval", reason="Approve this email?")


async def auto_approve(event: AfterInvocationEvent):
    if event.result and event.result.stop_reason == "interrupt":
        event.resume = [
            {"interruptResponse": {"interruptId": intr.id, "response": "approved"}}
            for intr in event.result.interrupts
        ]


agent = Agent(tools=[send_email])
agent.add_hook(require_approval)
agent.add_hook(auto_approve)

result = agent("Send an email to alice@example.com saying hello")
모든 인터럽트를 자동 승인하면 승인 절차를 둔 의미가 없어지므로, 실제 서비스에서는 auto_approve에 정책을 넣어 자동으로 처리해도 되는 경우에만 resume을 설정하고 그렇지 않으면 비워 둡니다. 그러면 인터럽트가 호출자에게 돌아가고, 사람이 판단한 응답으로 다시 호출하는 흐름으로 넘어갑니다.
미들웨어와 개입(Interventions)으로 흐름 제어하기
훅은 수명 주기 이벤트를 관찰하고 반응하는 데 맞춰져 있습니다. 모델 호출 하나를 캐시된 응답으로 대신하거나 도구 호출을 몇 번 다시 실행할지 정하려면 그 단계를 바깥에서 감싸는 장치가 필요한데, 미들웨어(middleware)가 이 일을 맡습니다. 여러 정책이 같은 도구 호출을 두고 "막는다", "고쳐서 다시 하라"를 동시에 말하면 개입 핸들러가 정리합니다. 스티어링(steering)은 규칙을 핸들러로 나눠, 도구 호출 직전이나 모델 응답 직후처럼 필요한 순간에만 모델에 지침을 줍니다.
미들웨어: 단계를 감싸서 실행 여부와 횟수를 정하기
단계(stage)는 실행 중에 가로챌 수 있는 지점이며 둘입니다. InvokeModelStage는 모델 호출 한 번을, ExecuteToolStage는 도구 호출 한 번을 감쌉니다. 단계마다 들어가는 컨텍스트(InvokeModelContext, ExecuteToolContext)와 나오는 결과(InvokeModelResult, ExecuteToolResult)가 있고, 핸들러는 둘 중 어느 쪽이든 바꿀 수 있습니다.
단계마다 실행 구간(phase)이 셋 있고, 핸들러는 그중 하나에 붙습니다. 등록 순서와 상관없이 항상 Input → Wrap → Output 순서로 실행됩니다.
- Input: 단계가 실행되기 전에 컨텍스트를 변환합니다.
- Wrap: 컨텍스트와
next함수를 받아next를 부를지, 부른다면 언제 부를지 정합니다. 한 번도 부르지 않으면 단계를 건너뛰고, 한 번 부르면 그대로 통과시키며, 여러 번 부르면 재시도합니다. - Output: 단계가 끝난 뒤 결과를 변환합니다.
등록은 agent.add_middleware()로 합니다. Wrap에는 단계 토큰 자체를, 순수 변환에는 InvokeModelStage.Input 같은 하위 토큰을 넘깁니다. 아래 코드는 입력이 큰 호출만 더 긴 컨텍스트를 지원하는 모델로 보내고, 모델 호출 시간을 잽니다.
import time

from strands import Agent
from strands.middleware import InvokeModelStage
from strands.models import BedrockModel

agent = Agent()
large_context_model = BedrockModel(model_id="global.anthropic.claude-sonnet-4-6")


def route_by_size(context):
    # 컨텍스트는 불변으로 다루고 replace()로 수정된 사본을 만듭니다.
    if (context.projected_input_tokens or 0) > 50_000:
        return context.replace(model=large_context_model)
    return context


async def timing(context, next_fn):
    start = time.monotonic()
    async for event in next_fn(context):
        yield event
    print(f"model call took {time.monotonic() - start:.2f}s")


agent.add_middleware(InvokeModelStage.Input, route_by_size)
agent.add_middleware(InvokeModelStage, timing)
교체한 모델은 이번 호출에만 적용되고 에이전트 상태는 바뀌지 않습니다. Python의 Wrap 핸들러는 비동기 제너레이터라 값을 반환할 수 없어서, 단계의 결과가 스트림 안의 이벤트(모델 호출이면 ModelStopReason, 도구 호출이면 ToolResultEvent)로 전달됩니다. 응답 캐시라면 적중했을 때 저장해 둔 ModelStopReason을 yield하고 next를 부르지 않습니다. 재시도 미들웨어를 쓰면 재시도 전략을 꺼야 둘이 중첩되지 않습니다.
훅은 미들웨어 체인을 바깥에서 감쌉니다. 캐시가 next 없이 응답해도 훅은 발생하고, 재시도해도 훅에는 한 쌍만 보이므로 시도별 관측은 미들웨어에 둡니다.
개입 핸들러: 타입이 지정된 결정을 반환하기
훅에서 event.cancel에 사유를 넣으면 프레임워크는 그것이 권한 거부인지 다시 시도하라는 조언인지 알 수 없고, 같은 이벤트를 여러 플러그인이 고치면 마지막에 쓴 값이 조용히 이깁니다. 개입 핸들러는 이벤트를 직접 고치지 않고 Proceed, Deny, Guide, Confirm, Transform 중 하나를 반환하며, 해석은 프레임워크가 맡습니다. 각 수명 주기 메서드는 내부에서 훅 콜백으로 등록됩니다.
InterventionHandler를 상속해 필요한 메서드만 재정의하고 interventions 옵션으로 등록합니다. 재정의하지 않은 메서드는 Proceed()를 반환합니다.
from strands import Agent
from strands.hooks import BeforeToolCallEvent
from strands.interventions import Deny, Guide, InterventionHandler, OnError, Proceed


class StrictAuth(InterventionHandler):
    name = "strict-auth"

    @property
    def on_error(self) -> OnError:
        return "deny"  # 핸들러가 예외를 던지면 거부로 처리합니다(fail-closed).

    def before_tool_call(self, event: BeforeToolCallEvent):
        if not self._check_permission(event.tool_use["name"]):
            return Deny(reason="Unauthorized")
        return Proceed()

    def _check_permission(self, tool_name: str) -> bool:
        # ... 외부 권한 서비스를 호출합니다. 서비스가 다운되면 여기서 예외가 납니다.
        return True


class EmailValidator(InterventionHandler):
    name = "email-validator"

    def before_tool_call(self, event: BeforeToolCallEvent):
        if event.tool_use["name"] == "send_email":
            if not event.tool_use.get("input", {}).get("subject"):
                return Guide(feedback="All emails must include a subject line.")
        return Proceed()


agent = Agent(
    tools=[send_email, delete_file],
    interventions=[StrictAuth(), EmailValidator()],
)
핸들러는 등록 순서대로 평가되고, 결정이 겹치면 deny > confirm > guide > transform > proceed 순으로 우선합니다. Deny가 나오면 남은 핸들러는 건너뛰고, 여러 Guide는 모델에 보낼 메시지 하나로 합쳐집니다. Confirm은 before_tool_call에서만 쓸 수 있고 인터럽트로 승인을 기다립니다. after_tool_call은 Proceed와 Transform만, after_model_call은 Proceed, Guide, Transform만 받습니다. after_model_call의 Guide는 모델 재시도를 일으키는데 프레임워크가 횟수를 제한하지 않으므로, 핸들러가 직접 횟수를 세다가 반복 실패하면 Deny로 넘어가야 합니다.
on_error의 기본값 'throw'는 호출을 실패시키고, 'proceed'는 로그를 남기고 계속하며, 'deny'는 로그를 남기고 거부로 처리합니다. 보안 핸들러에는 'deny'를, 로깅처럼 가용성이 중요한 핸들러에는 'proceed'를 씁니다.
스티어링: 필요한 순간에 주는 지침
단계가 수십 개인 작업의 규칙을 모두 시스템 프롬프트에 넣으면 모델이 지시를 놓치기 쉽습니다. 스티어링 핸들러는 도구 호출 전에는 진행, 가이드(호출 취소 후 피드백 전달), 사람에게 묻기 중 하나를 고르고, 모델 응답 후에는 그대로 받아들이거나 응답을 버리고 지침을 넣어 재시도합니다. Python에서는 스티어링 핸들러가 플러그인이고, TypeScript에서는 개입 프레임워크 위에 만들어집니다.
LLMSteeringHandler는 자연어 규칙을 받아 판단을 LLM에 맡기고, 기본으로 도구 원장(tool ledger) 제공자가 기록한 도구 호출 이력(이름, 입력, 실행 상태, 결과)을 근거로 씁니다.
from strands import Agent, tool
from strands.vended_plugins.steering import LLMSteeringHandler


@tool
def send_email(recipient: str, subject: str, message: str) -> str:
    """Send an email to a recipient."""
    return f"Email sent to {recipient}"


handler = LLMSteeringHandler(
    system_prompt="""
    You are providing guidance to ensure emails maintain a cheerful, positive tone.

    Guidance:
    - Review email content for tone and sentiment
    - Suggest more cheerful phrasing if the message seems negative or neutral
    - Encourage use of positive language and friendly greetings
    """
)

agent = Agent(tools=[send_email], plugins=[handler])
agent(
    "Send a frustrated email to tom@example.com, "
    "a client who keeps rescheduling important meetings at the last minute"
)
보통은 첫 send_email 호출이 취소되고 지침 메시지가 들어간 뒤, 더 밝은 문구로 다시 호출됩니다. 판단마다 평가 모델을 한 번 더 부르므로, 코드로 쓸 수 있는 규칙은 개입 핸들러로, 맥락 판단이 필요한 규칙만 스티어링으로 처리하는 편이 비용 면에서 유리합니다.
세 방식 비교
| 구분 | 미들웨어 | 개입 핸들러 | 스티어링 |
|---|---|---|---|
| 개입 지점 | 모델 호출·도구 호출 단계 | 호출 시작, 모델 호출 전후, 도구 호출 전후 | 도구 호출 전, 모델 응답 후 |
| 제어 방식 | 컨텍스트·결과 변환과 next 호출 횟수 |
타입이 지정된 다섯 가지 결정 | 진행·가이드·사람 확인 결정 |
| 등록 방법 | agent.add_middleware() |
Agent(interventions=[...]) |
Python은 plugins, TypeScript는 interventions |
| 상태 영향 | 해당 호출에만 적용되는 변경 | 프레임워크가 결정을 해석해 취소·피드백·변환으로 반영 | 대화에 주입되는 피드백 |
| 적합한 용도 | 캐시, 재시도, 모델 라우팅, context.interrupt() 기반 승인 관문 |
권한, 가드레일, 내용 변환, Confirm 승인 |
맥락에 따른 절차 준수와 어조 교정 |
재시도 전략
모델 제공자는 가끔 속도 제한, 서비스 일시 중단, 네트워크 타임아웃 같은 오류를 돌려줍니다. 에이전트 루프 중간에 모델 호출 하나가 실패할 때마다 호출 전체가 끝나 버리면, 길게 이어 온 작업이 일시적인 문제 하나 때문에 사라집니다. Strands는 에이전트에 재시도 전략을 붙여 이 문제를 처리합니다. 아무것도 설정하지 않아도 스로틀링(throttling) 응답은 지수 백오프(exponential backoff)로 자동 재시도됩니다. 이 동작은 생성자의 retry_strategy 매개변수(TypeScript에서는 retryStrategy)로 바꿉니다.
기본 동작: 스로틀링만, 지수 백오프로
기본 재시도 전략은 스로틀링 오류를 최대 5번 재시도합니다. 첫 시도를 포함하면 모두 6번입니다. 대기 시간은 4초에서 시작해 재시도할 때마다 두 배가 됩니다.
Attempt 1: fails → wait 4s
Attempt 2: fails → wait 8s
Attempt 3: fails → wait 16s
Attempt 4: fails → wait 32s
Attempt 5: fails → wait 64s
Attempt 6: fails → exception raised
Python에서 \(n\)번째 재시도 전의 대기 시간 \(d_n\)은 초기 대기 시간에 2의 거듭제곱을 곱하고 상한으로 자릅니다.
\[d_n = \min\left(\text{initial\_delay} \cdot 2^{\,n-1},\ \text{max\_delay}\right)\]기본값 max_delay=128은 기본 횟수 안에서는 닿지 않습니다. 이 상한은 max_attempts를 늘렸을 때 대기 시간이 끝없이 커지지 않게 막습니다.
재시도 대상은 모델 제공자가 속도 제한으로 던지는 ModelThrottledException(TypeScript에서는 ModelThrottledError)뿐입니다. 다른 예외는 재시도 없이 바로 전파됩니다. 스로틀링은 기다리면 풀릴 가능성이 높지만, 잘못된 요청이나 권한 오류는 몇 번을 다시 보내도 결과가 같기 때문입니다.
매개변수 조정과 재시도 끄기
설정을 바꾸려면 구성한 전략 객체를 생성자에 넘깁니다. 대화형 서비스처럼 사용자가 1분 넘게 기다릴 수 없다면 횟수와 대기 시간을 줄입니다. 배치 작업처럼 끝까지 완료하는 편이 중요하다면 횟수를 늘리고 상한을 둡니다.
from strands import Agent, ModelRetryStrategy

# 대화형 요청: 시도 3번(첫 시도 포함), 2초에서 시작, 대기는 최대 60초
interactive_agent = Agent(
    retry_strategy=ModelRetryStrategy(
        max_attempts=3,
        initial_delay=2,
        max_delay=60,
    )
)

# 재시도를 완전히 끕니다.
no_retry_agent = Agent(retry_strategy=None)
재시도를 끄는 방법은 두 가지입니다. retry_strategy=None을 넘기거나, max_attempts=1로 첫 시도만 하게 합니다. Python과 TypeScript는 백오프를 노출하는 방식이 다릅니다.
| 구분 | Python | TypeScript |
|---|---|---|
| 기본 전략 클래스 | ModelRetryStrategy |
DefaultModelRetryStrategy(ModelRetryStrategy는 추상 기반 클래스) |
| 시도 횟수 | max_attempts(기본 6) |
maxAttempts(기본 6, 1 이상) |
| 대기 시간 설정 | initial_delay(기본 4초), max_delay(기본 128초) |
backoff에 BackoffStrategy 전달(기본 ExponentialBackoff({ baseMs: 4000, maxMs: 240000 })) |
| 백오프 종류 | 지수 백오프만 지원 | ExponentialBackoff, LinearBackoff, ConstantBackoff |
| 지터(jitter) | 별도 옵션 없음 | ExponentialBackoff, LinearBackoff의 jitter: 'none', 'full', 'equal', 'decorrelated'(기본 'full') |
| 재시도 끄기 | retry_strategy=None |
retryStrategy: null |
TypeScript의 ExponentialBackoff는 대기 시간을 baseMs * multiplier^(attempt-1)로 계산해 maxMs에서 자릅니다. LinearBackoff는 baseMs * attempt로 늘리고 역시 maxMs에서 자릅니다. 기본 지터 'full'은 대기 시간을 구간 안에 무작위로 흩뜨려서, 같은 제한에 걸린 여러 클라이언트가 같은 순간에 다시 몰려드는 일을 줄입니다. 인스턴스를 여러 개 띄운 서비스에서 특히 효과가 큽니다. ConstantBackoff는 설정한 대기 시간을 그대로 씁니다.
import { Agent, DefaultModelRetryStrategy, ExponentialBackoff } from '@strands-agents/sdk'

const agent = new Agent({
  retryStrategy: new DefaultModelRetryStrategy({
    maxAttempts: 4,
    backoff: new ExponentialBackoff({
      baseMs: 2_000,
      maxMs: 60_000,
      multiplier: 2,
      jitter: 'full',
    }),
  }),
})
재시도할 오류 넓히기와 좁히기
자체 게이트웨이를 거쳐 모델을 호출해서 타임아웃이 잦다면 스로틀링 말고도 재시도할 오류가 생깁니다. 이때는 ModelRetryStrategy를 상속해 is_retryable만 재정의합니다. super().is_retryable(exception)을 함께 부르면 스로틀링 재시도는 그대로 두고 오류 타입만 추가합니다. 백오프 계산이나 대기 같은 나머지 정책은 다시 구현하지 않아도 됩니다. 특정 오류를 빼고 싶을 때도 같은 자리에서 조건을 좁힙니다.
from strands import Agent, ModelRetryStrategy


class MyRetryStrategy(ModelRetryStrategy):
    def is_retryable(self, exception: Exception) -> bool:
        # 기본 재시도 대상(스로틀링)에 타임아웃을 추가합니다.
        return super().is_retryable(exception) or isinstance(exception, TimeoutError)


agent_a = Agent(retry_strategy=MyRetryStrategy(max_attempts=4, initial_delay=2, max_delay=60))
agent_b = Agent(retry_strategy=MyRetryStrategy(max_attempts=4, initial_delay=2, max_delay=60))
전략 인스턴스는 턴마다 상태를 들고 있어서 여러 에이전트가 공유하면 안 됩니다. 위 코드처럼 에이전트마다 새 인스턴스를 만듭니다. TypeScript에서는 DefaultModelRetryStrategy를 상속해 isRetryable을 재정의합니다. 시도 횟수에 따라 판단을 바꾸거나 백오프 상태를 직접 관리하려면, TypeScript에서는 추상 클래스 ModelRetryStrategy를 상속해 computeRetryDecision을 구현합니다. 이 경우에도 단락 처리, 턴 단위 상태 초기화, 시도 사이 대기는 기반 클래스가 맡습니다.
훅 기반 재시도
모델 오류를 확인하고 재시도만 요청하면 된다면 훅이 더 간단합니다. AfterModelCallEvent 콜백에서 event.retry = True를 설정하면 모델 호출이 다시 실행됩니다. 판단 기준에 제한이 없어서 예외뿐 아니라 응답 검증이나 내용 품질 검사 결과로도 재시도를 요청할 수 있습니다. 다만 훅은 대기 시간을 자동으로 넣지 않으므로 백오프를 직접 구현합니다. 횟수 카운터도 직접 관리해야 하고, 초기화하지 않으면 한 번 소진된 재시도 횟수가 이후 호출로 이어집니다. 아래 코드는 BeforeInvocationEvent에서 호출마다 카운터를 초기화하고, ServiceUnavailable 오류에만 지수적으로 늘어나는 대기를 넣습니다.
import asyncio
import logging

from strands import Agent
from strands.hooks import AfterModelCallEvent, BeforeInvocationEvent, HookProvider, HookRegistry

logger = logging.getLogger(__name__)


class RetryOnServiceUnavailable(HookProvider):
    """Retry model calls when ServiceUnavailable errors occur."""

    def __init__(self, max_retries: int = 3):
        self.max_retries = max_retries
        self.retry_count = 0

    def register_hooks(self, registry: HookRegistry) -> None:
        registry.add_callback(BeforeInvocationEvent, self.reset_counts)
        registry.add_callback(AfterModelCallEvent, self.handle_retry)

    def reset_counts(self, event: BeforeInvocationEvent = None) -> None:
        self.retry_count = 0

    async def handle_retry(self, event: AfterModelCallEvent) -> None:
        if event.exception:
            if "ServiceUnavailable" in str(event.exception) and self.retry_count < self.max_retries:
                self.retry_count += 1
                logger.info(f"Retrying model call ({self.retry_count}/{self.max_retries})")
                event.retry = True
                await asyncio.sleep(2 ** self.retry_count)  # 훅은 대기를 직접 넣어야 합니다.
        else:
            self.reset_counts()  # 성공하면 카운터를 되돌립니다.


agent = Agent(hooks=[RetryOnServiceUnavailable(max_retries=3)])
result = agent("What is the capital of France?")
TypeScript의 AfterModelCallEvent에는 1부터 세는 attemptCount가 있습니다. 그래서 훅 밖에 상태를 두지 않고도 event.attemptCount <= maxRetries처럼 횟수를 제한할 수 있습니다.
도구 호출도 같은 방식으로 재시도합니다. AfterToolCallEvent에서 event.retry = True를 설정하면 도구 실행기가 현재 결과를 버리고 같은 tool_use_id로 도구를 다시 실행합니다. 불안정한 외부 API처럼 일시적 오류가 잦은 도구에 적합합니다. 재시도 횟수는 훅이 직접 셉니다. 예를 들어 tool_use_id별로 세다가 도구가 성공하면 그 항목을 지웁니다. 스트리밍을 소비하는 쪽은 주의할 점이 있습니다. 버려진 시도의 ToolStreamEvent는 이미 호출자에게 전달된 뒤이고, 대화 기록에는 마지막 시도의 ToolResultEvent만 들어갑니다. 진행률 UI는 같은 도구의 진행 이벤트가 처음부터 다시 올 수 있다고 보고 만들어야 합니다.
어느 방식을 고를지는 무엇을 근거로 재시도를 판단하느냐에 따라 정합니다. 오류 타입만 보고 결정하면서 백오프와 상태 초기화를 SDK에 맡기려면 재시도 전략 서브클래스를 씁니다. 응답 내용 검증처럼 오류 이외의 조건을 보거나 도구 호출까지 재시도하려면 훅을 씁니다.
대화 관리와 컨텍스트 윈도우
에이전트 루프는 반복할 때마다 어시스턴트 응답과 도구 결과를 대화 기록에 쌓고, 다음 모델 호출 때 그 기록을 통째로 다시 보냅니다. 짧은 질의응답이라면 문제가 없지만, 도구를 수십 번 부르는 작업이나 여러 차례 이어지는 대화에서는 기록이 모델의 토큰 한도에 금방 다가갑니다. 대화 매니저는 이 기록을 컨텍스트 윈도우 안에 맞춰 두는 장치입니다. 오래된 메시지를 잘라 내거나 요약하면서 아직 필요한 메시지는 남깁니다. 에이전트 루프 안에서 동작하므로 메시지가 쌓이는 동안 별도 코드 없이 기록을 관리합니다.
매니저를 고르는 일은 무엇을 버릴지 고르는 일입니다. 버리는 방식에 따라 초반 맥락의 보존 정도와 추가 모델 호출 비용이 달라집니다.
내장 대화 매니저 세 가지
내장 매니저는 모두 ConversationManager 인터페이스를 구현하며, 기록을 줄이는 전략만 다릅니다.
| 구분 | NullConversationManager |
SlidingWindowConversationManager |
SummarizingConversationManager |
|---|---|---|---|
| 기록 처리 방식 | 기록을 건드리지 않음 | 최근 메시지를 정해진 개수만큼 유지 | 오래된 메시지를 요약으로 대체 |
| 오래된 맥락 | 전부 보존 | 창 밖으로 밀린 메시지는 사라짐 | 요약 형태로 남음 |
| 추가 모델 호출 | 없음 | 없음 | 요약 생성 호출 |
| 기본값 여부 | 명시적으로 넘겨야 사용 | 매니저를 지정하지 않을 때의 기본값 | 명시적으로 넘겨야 사용 |
| 적합한 상황 | 짧은 대화, 디버깅, 직접 관리 | 일반적인 대화와 도구 사용 루프 | 초반 결정과 맥락이 끝까지 중요한 긴 작업 |
가장 흔한 실수는 매니저를 끌 때 나옵니다. conversation_manager를 생략하거나 conversation_manager=None을 넘기면(TypeScript에서는 conversationManager: undefined) 기록 정리가 꺼지지 않고 기본 슬라이딩 윈도우(sliding window)가 선택됩니다. 전체 기록을 그대로 두려면 NullConversationManager 인스턴스를 명시적으로 넘겨야 합니다.
from strands import Agent
from strands.agent.conversation_manager import NullConversationManager

# None이 아니라 인스턴스를 넘겨야 기본 슬라이딩 윈도우가 꺼집니다.
agent = Agent(conversation_manager=NullConversationManager())
슬라이딩 윈도우와 도구 결과 잘라 내기
슬라이딩 윈도우 매니저는 최근 메시지를 정해진 개수만큼 유지합니다. 메시지 수가 window_size를 넘으면 메시지를 창 밖으로 내보내고, 컨텍스트 윈도우 초과 오류가 나면 요청이 모델 컨텍스트에 들어갈 때까지 가장 오래된 메시지부터 잘라 냅니다. 단순히 앞에서부터 자르기만 하지는 않습니다. 짝이 맞지 않는 불완전한 메시지 시퀀스도 정리해서 대화 상태를 유효하게 유지합니다.
메시지 하나가 너무 커서 문제인 경우도 있습니다. 파일 전체를 읽은 도구 결과 하나가 컨텍스트 대부분을 차지하면, 메시지 개수를 줄이는 것만으로는 대응이 늦습니다. should_truncate_results를 켜 두면(기본값입니다) 메시지가 컨텍스트 한도를 넘을 때 도구 결과를 잘라 냅니다. 가장 오래된 도구 결과 메시지부터 잘라서 최근 맥락을 최대한 오래 지킵니다. 잘라 내는 방식은 콘텐츠 종류마다 다릅니다.
- 텍스트는 앞부분과 뒷부분을 남기고 그 사이에
<truncated chars="N"/>표시를 넣습니다. - 이미지, 동영상, 바이너리 문서, 지나치게 큰 JSON은
[image: png, source: bytes, 12345 bytes]같은 타입별 자리 표시자로 바뀝니다. - 도구 결과의 원래
status와error필드는 그대로 남습니다.
이 옵션을 끄면 도구 결과는 온전히 보존되는 대신 과거 메시지가 더 많이 삭제될 수 있습니다. 전체 내용을 외부에 보존하는 선제적 대안으로는 Context Offloader 플러그인이 있습니다.
기본 상태의 슬라이딩 윈도우는 에이전트 루프가 끝난 뒤에만 기록을 정리합니다. 사용자 요청 하나에 도구를 수십 번 부르는 작업이라면 루프 도중에 기록이 한도에 닿습니다. Python에서는 per_turn으로 정리 시점을 앞당깁니다. False(기본값)는 루프가 끝난 뒤에만, True는 모든 모델 호출 직전에, 0보다 큰 정수 N은 모델 호출 N번마다 정리합니다. TypeScript는 per_turn을 지원하지 않습니다.
from strands import Agent
from strands.agent.conversation_manager import SlidingWindowConversationManager

conversation_manager = SlidingWindowConversationManager(
    window_size=20,               # 유지할 최대 메시지 수
    should_truncate_results=True, # 메시지가 컨텍스트 한도를 넘으면 도구 결과를 잘라 냅니다.
    per_turn=3,                   # 모델 호출 3번마다 정리합니다.
)

agent = Agent(conversation_manager=conversation_manager)
TypeScript에서는 window_size와 should_truncate_results를 windowSize, shouldTruncateResults처럼 카멜 표기로 넘깁니다.
요약 매니저
SummarizingConversationManager는 오래된 메시지를 버리지 않고 요약해서 바꿔 넣습니다. 컨텍스트를 줄여야 할 때 가장 오래된 메시지 중 summary_ratio만큼을 요약으로 대체하고, 최근 메시지는 preserve_recent_messages개 이상 항상 남깁니다. summary_ratio의 기본값은 0.3이며 0.1에서 0.8 사이로 제한되고, preserve_recent_messages의 기본값은 10입니다. 요약하는 동안에도 도구 요청과 결과 메시지 쌍은 함께 유지되고, 요약이 실패해도 매니저가 안전하게 처리합니다.
기본 요약 프롬프트는 주요 주제, 사용한 도구, 기술 정보에 초점을 맞춘 3인칭 글머리표 요약을 만듭니다. 도메인에 맞는 정보를 지켜야 한다면 summarization_system_prompt로 프롬프트를 바꿉니다. 코드 작업이라면 함수 이름과 파일 경로를 반드시 남기라고 지시하는 식입니다. 요약이 부정확하면 이후 턴이 모두 그 요약 위에서 진행되므로, 보존할 항목은 프롬프트에 명시해 둡니다.
요약에 쓰는 모델도 바꿀 수 있습니다. 기본으로는 agent.aux_model(TypeScript에서는 agent.auxModel)로 요약합니다. Python에서는 summarization_agent에 별도 에이전트를 넘기면 더 빠르거나 저렴한 모델로 요약하고, 요약 중에 도구를 실행하거나 도메인 전용 로직을 넣을 수 있습니다. 이 에이전트는 자신의 시스템 프롬프트와 도구, 모델 구성을 씁니다. summarization_system_prompt와 함께 쓸 수 없습니다.
from strands import Agent
from strands.agent.conversation_manager import SummarizingConversationManager
from strands.models import AnthropicModel

# 요약에는 더 저렴하고 빠른 모델을 씁니다.
summarization_model = AnthropicModel(
    model_id="claude-haiku-4-5-20251001",
    max_tokens=1000,
    params={"temperature": 0.1},  # 일관된 요약을 위해 낮은 온도를 씁니다.
)
custom_summarization_agent = Agent(model=summarization_model)

conversation_manager = SummarizingConversationManager(
    summary_ratio=0.4,
    preserve_recent_messages=8,
    summarization_agent=custom_summarization_agent,
)

agent = Agent(conversation_manager=conversation_manager)
TypeScript에서는 도구나 훅을 갖춘 에이전트 전체를 요약용으로 주입할 수 없고, 대신 model 옵션으로 요약 모델만 바꿉니다. 주요 옵션은 summaryRatio, preserveRecentMessages, summarizationSystemPrompt, proactiveCompression입니다.
메시지 고정
어떤 메시지는 대화가 아무리 길어져도 남아 있어야 합니다. 작업 초반에 사용자가 준 핵심 지시나 중간에 내린 중요한 결정이 그렇습니다. 메시지 고정은 이런 메시지가 컨텍스트 축소 과정에서 밀려나지 않게 보호하고, 슬라이딩 윈도우의 잘라 내기와 요약 양쪽에 모두 적용됩니다.
메시지 객체에 metadata.custom.pinned = true를 설정하면 그 메시지가 고정됩니다. 가장 간단한 방법은 두 매니저가 모두 받는 pin_first(TypeScript에서는 pinFirst)로 처음 N개 메시지를 영구히 보호하는 것입니다. 실행 중에 메시지를 골라 고정하는 유틸리티 함수도 SDK에 들어 있습니다.
from strands import Agent
from strands.agent.conversation_manager import SlidingWindowConversationManager

agent = Agent(
    conversation_manager=SlidingWindowConversationManager(
        window_size=40,
        pin_first=1,  # 첫 사용자 지시는 어떤 축소에서도 남깁니다.
    )
)
고정 메타데이터는 첫 컨텍스트 축소 때 기록되고, 이후 모든 축소에서 계속 유지됩니다. 고정 메시지는 어떤 축소에서도 남으므로 꼭 필요한 메시지만 고정합니다.
선제적 압축
기본 대화 매니저는 사후 대응 방식입니다. 모델이 컨텍스트 윈도우 초과 오류로 요청을 거부한 뒤에야 기록을 줄입니다. 그러면 실패할 요청을 한 번 보내느라 왕복 시간이 낭비되고, 입력이 한도 가까이 차서 출력에 쓸 토큰이 모자라는 일도 생깁니다. 선제적 압축(proactive compression)은 모델을 호출하기 전에 예상 입력 토큰 수가 컨텍스트 윈도우의 일정 비율을 넘으면 미리 기록을 줄입니다.
모델을 호출하기 전마다 에이전트는 예상 입력 토큰 수를 추정해 BeforeModelCallEvent에 붙이고, 매니저는 이 값을 모델의 contextWindowLimit과 비교합니다.
이 조건을 만족하면 사후 대응 때와 같은 축소 로직을 미리 실행합니다. BeforeModelCallEvent는 도구 사용 사이클 안의 모델 호출 직전에도 발생하므로 루프 도중에도 압축이 일어납니다. 호출 한 번에 도구를 다섯 번 부르는 에이전트에서 세 번째와 네 번째 호출 사이에 임계값을 넘으면, 네 번째 호출 직전에 압축합니다.
예시(설명용 가상 수치): 컨텍스트 윈도우가 200,000토큰인 모델에 임계값 0.7을 쓰면, 예상 입력이 140,000토큰 이상인 호출부터 압축이 시작됩니다. 도구 결과가 쌓여 세 번째 호출 직전 예상치가 120,000토큰이면 비율이 0.6이라 그대로 호출하고, 큰 도구 결과가 붙어 네 번째 호출 직전 예상치가 150,000토큰이 되면 비율이 0.75라 축소부터 합니다.
proactive_compression=True를 넘기면 기본 임계값 0.7을 쓰고, 0과 1 사이의 비율을 직접 정하려면 딕셔너리로 넘깁니다. 모든 내장 매니저가 이 옵션을 받고, 지정하지 않으면 사후 복구만 동작합니다.
from strands import Agent
from strands.agent.conversation_manager import (
    SlidingWindowConversationManager,
    SummarizingConversationManager,
)

sliding_agent = Agent(
    conversation_manager=SlidingWindowConversationManager(
        window_size=50,
        proactive_compression={"compression_threshold": 0.7},
    ),
)

summarizing_agent = Agent(
    conversation_manager=SummarizingConversationManager(
        proactive_compression=True,  # 기본 임계값 0.7
    ),
)
선제적 압축은 최선 노력(best-effort) 방식입니다. 축소가 예외를 던지거나 아무것도 줄이지 못해도 오류는 삼켜지고 모델 호출은 그대로 진행됩니다. 따라서 이 옵션을 켰다고 초과 오류가 사라지지는 않으며, 그때는 사후 복구가 이어서 처리합니다. 임계값을 낮추면 출력 토큰 여유가 커지는 대신 압축이 잦아지고, 요약 매니저라면 요약 호출 비용도 그만큼 늘어납니다.
사용자 정의 대화 매니저
내장 전략이 맞지 않으면 직접 만듭니다. Python에서는 ConversationManager 인터페이스를 구현하며, 다음 요소로 구성됩니다.
apply_management: 이벤트 루프 사이클이 끝날 때마다 호출되어, 도구 결과와 어시스턴트 응답이 더해진 메시지 배열에 관리 전략을 적용합니다.reduce_context: 컨텍스트 윈도우 초과 예외가 났을 때 호출됩니다. 에이전트가 다시 시도하기 전에 기록을 줄일 기회입니다.removed_message_count: 매니저가 에이전트 메시지에서 제거한 사용자·모델 메시지 수입니다. 세션 관리가 저장소에서 메시지를 효율적으로 불러올 때 이 값을 쓰므로, 요약처럼 매니저가 추가한 메시지는 세지 않습니다.register_hooks(선택): 모델 호출 전에 기록을 다듬는 것처럼 훅과 연동할 때 재정의합니다. 재정의할 때는 반드시super().register_hooks를 호출합니다.
TypeScript에서는 추상 클래스 ConversationManager를 상속해 reduce를 구현합니다. 이 메서드는 두 상황에서 불립니다. ContextWindowOverflowError가 났을 때는 options.error가 설정된 채로, 임계값을 넘은 모델 호출 직전에는 options.error가 undefined인 채로 불립니다. agent.messages를 직접 수정해 기록을 줄이고, 줄였다면 true를 반환합니다. 반환값의 의미는 상황마다 다릅니다. 오류가 설정된 경우 false를 반환하면 오류가 에이전트 루프 밖으로 전파되고, 오류가 없는 경우에는 false를 반환하거나 예외를 던져도 모델 호출이 그대로 진행됩니다.
import {
  Agent,
  ConversationManager,
  type ConversationManagerReduceOptions,
} from '@strands-agents/sdk'

class Last10MessagesManager extends ConversationManager {
  readonly name = 'my:last-10-messages'

  reduce({ agent }: ConversationManagerReduceOptions): boolean {
    if (agent.messages.length <= 10) return false
    agent.messages.splice(0, agent.messages.length - 10)
    return true
  }
}

const agent = new Agent({
  conversationManager: new Last10MessagesManager(),
})
이 예제는 최근 10개만 남기는 단순한 전략이라, 슬라이딩 윈도우가 해 주는 불완전한 메시지 정리가 없습니다. 잘라 낸 경계가 도구 요청과 결과 쌍 사이에 걸리면 기록이 유효하지 않게 되므로, 실제 매니저에서는 경계를 쌍 단위로 맞춥니다. 호출이 끝날 때마다 다듬는 식의 선제적 관리를 더하려면 initAgent를 재정의해 AfterInvocationEvent 같은 훅을 붙이고, 이때 super.initAgent(agent)를 반드시 호출해 내장 초과 복구와 선제적 압축 훅을 유지합니다. 두 언어 모두 내장 SlidingWindowConversationManager 구현을 참고 예제로 삼기 좋습니다.
수명 주기 제어: 호출 제한, 취소, 동시성
에이전트 인스턴스 하나에 보낸 프롬프트는 제한을 두지 않으면 예상보다 오래 루프를 돌고, 예산보다 많은 토큰을 쓰고, 호출자가 떠난 뒤에도 계속 실행됩니다. 프로덕션에서는 호출 하나가 할 수 있는 일의 양에 상한을 두고, 필요할 때 실행을 멈추고, 같은 인스턴스로 요청이 겹칠 때의 동작을 정해 두어야 합니다. Strands의 에이전트 루프는 이 세 가지를 호출 제한, 취소, 동시 호출 모드로 제공합니다. 셋은 서로 독립적으로 동작하므로 필요한 것만 골라 씁니다.
턴과 토큰 제한
호출 제한은 프롬프트와 함께 limits 딕셔너리로 넘깁니다. 턴 수(루프 반복 횟수)를 제한하는 turns, 출력 토큰을 제한하는 output_tokens, 전체 토큰을 제한하는 total_tokens가 있고 셋 다 선택 항목입니다. 각 값은 양의 정수여야 하며, 동기 호출뿐 아니라 invoke_async와 stream_async에도 같은 매개변수를 씁니다. TypeScript에서는 invoke나 stream의 옵션에 limits: { turns, outputTokens, totalTokens }를 넘기고, 각 값은 양의 유한한 수여야 합니다.
기본으로는 아무 제한도 걸려 있지 않습니다. 모델이 도구 요청을 멈출 때까지 에이전트가 계속 돌고, 턴마다 그때까지의 대화를 다시 보냅니다. 장시간 실행되거나 자율적으로 움직이는 에이전트에는 턴 제한이나 전체 토큰 제한, 또는 둘 다를 거는 편이 좋습니다.
제한은 호출 도중이 아니라 각 루프 반복의 맨 앞에서 검사합니다. 이 검사 시점이 동작을 이해하는 핵심입니다. 모델 응답 하나가 진행되는 동안에는 예산을 넘어도 끊기지 않으므로 한 턴이 토큰 예산을 초과할 수 있습니다. 직전 턴이 요청한 도구도 항상 끝까지 실행된 뒤에 검사가 일어납니다. 그래서 대화 기록이 다시 호출할 수 있는 유효한 상태로 유지됩니다. 상한을 여러 개 동시에 넘으면 종료 이유는 턴, 전체 토큰, 출력 토큰 순서로 우선합니다.
예시(설명용 가상 수치로 따라간 실행): total_tokens=10000으로 호출했다고 가정합니다. 첫 턴이 누적 3,000토큰, 둘째 턴이 누적 7,500토큰을 쓰고, 셋째 턴의 모델 응답이 도구를 요청하면서 누적 11,500토큰이 됩니다. 셋째 턴 시작 시점에는 7,500토큰이라 검사를 통과했으므로 응답은 끊기지 않고 예산을 넘깁니다. 이어서 셋째 턴이 요청한 도구가 끝까지 실행되고 결과가 기록에 들어간 뒤, 넷째 턴의 맨 앞에서 검사가 걸려 limit_total_tokens로 끝납니다. 예산을 정할 때는 한 턴 분량만큼 초과할 수 있다고 보고 여유를 둡니다.
제한은 현재 호출에만 적용됩니다. 에이전트를 재사용하면 호출마다 카운터가 새로 시작되므로, 예산을 다 써서 멈춘 에이전트에 더 큰 예산으로 다시 호출하면 쌓인 기록 위에서 이어 갑니다.
from strands import Agent

agent = Agent(callback_handler=None)

result = agent(
    "Review the attached incident notes and list the root causes.",
    limits={"turns": 5, "total_tokens": 10_000},
)

if result.stop_reason in ("limit_turns", "limit_total_tokens"):
    # 기록이 유효한 상태로 남아 있으므로, 같은 에이전트에 더 큰 예산으로 다시 호출합니다.
    # 카운터는 호출마다 새로 시작합니다.
    result = agent(
        "Continue the review and finish the list.",
        limits={"turns": 10, "total_tokens": 30_000},
    )
무엇이 토큰 제한에 포함되는지는 언어마다 다릅니다. Python에서는 이 에이전트 자신의 모델 호출만 셉니다. 도구로 호출한 다른 에이전트나 대화 매니저의 요약 호출은 제한 밖에서 실행되고 사용량에도 더해지지 않습니다. 도구로 쓰는 에이전트까지 제한하려면 직접 작성한 도구 안에서 그 에이전트를 호출하면서 limits를 넘깁니다. TypeScript에서는 제한이 요청 전체에 적용됩니다. 도구로 넘긴 에이전트는 요청의 제한과 사용량을 공유하고, 직접 작성한 도구가 호출하는 에이전트는 그 도구가 context.invocationContext를 넘길 때만 요청에 합류하며 그렇지 않으면 자체 제한으로 실행됩니다. 요약 같은 보조 모델 호출은 사용량에 토큰을 더하지만 제한에 묶이지는 않습니다.
전체 토큰 제한은 각 모델 호출이 보고하는 전체 토큰을 더해서 계산합니다. Amazon Bedrock, Anthropic, OpenAI, Google Gemini에서는 이 합계에 프롬프트 캐시 읽기와 쓰기가 모두 포함되므로, 캐시를 적중한 턴도 그렇지 않은 턴과 같은 양의 제한을 소모합니다. 프롬프트 캐싱은 재전송 비용을 줄여 주지만 이 제한은 비용이 아니라 토큰을 제한합니다. 턴마다 보내는 양 자체를 줄이려면 컨텍스트 관리로 기록을 줄여야 합니다.
취소: 체크포인트와 외부 신호
클라이언트 연결이 끊기거나, 시간 제한을 넘기거나, 사용자가 "중지" 버튼을 누르면 루프 바깥에서 실행을 멈춰야 합니다. 취소에는 두 가지 방법이 있습니다. 하나는 agent.cancel()로, 에이전트 내부 신호를 설정합니다. 다른 하나는 호출할 때 cancel_signal로 외부 신호를 넘기는 방법입니다. 멈추는 이유가 특정 요청에 속한다면 호출 단위 신호를 쓰고, 실행 중인 에이전트는 다른 컴포넌트가 가지고 있는데 그 신호에는 접근할 수 없다면 agent.cancel()을 씁니다.
에이전트는 신호를 아무 때나 확인하지 않고 정해진 체크포인트에서만 확인합니다. 신호가 설정된 것을 확인하면 stop_reason이 cancelled인 결과를 반환합니다. Python SDK의 체크포인트는 넷입니다.
| 체크포인트 | 동작 | 비고 |
|---|---|---|
| 모델 응답 스트리밍 중 | 부분 출력을 버립니다. | 모델이 마지막 메타데이터 이벤트를 보내기 전에 스트림을 닫으므로 사용량 메트릭이 부정확할 수 있습니다. |
| 도구 실행 전 | 도구 호출을 건너뛰고, 대화 상태가 유효하도록 오류 결과를 넣습니다. | 순차 실행기에서는 시작하지 않은 도구를 건너뛸 수 있습니다. |
| MCP 도구 실행 중 | 공유 MCP 세션은 닫지 않고 진행 중인 MCP 요청만 취소합니다. | 원격 취소는 최선 노력 방식이어서 서버가 응답하지 않아도 로컬에서는 멈춥니다. |
| 도구 실행 후 | 다음 모델 호출 전에 멈춥니다. | MCP가 아닌 도구는 끝까지 실행된 뒤에 취소를 확인합니다. |
TypeScript SDK의 체크포인트는 각 루프 사이클의 맨 앞, 모델 응답 스트리밍 중, 도구 실행 전, 순차 도구 실행 사이입니다. 도구 실행 전이나 순차 실행 사이에서 취소되면 남은 도구 호출은 오류 결과로 건너뜁니다.
취소된 결과에서는 조립 중이던 불완전한 모델 메시지가 결과와 기록에서 모두 빠집니다. 이미 소비자에게 전달된 스트리밍 델타는 그대로 보이므로, UI가 부분 텍스트를 화면에 그렸다면 취소되었다는 표시를 따로 붙이는 편이 좋습니다. 내부 신호는 호출이 끝나면 자동으로 해제되어 에이전트를 바로 다시 쓸 수 있습니다. agent.cancel()은 멱등적이라 여러 번 불러도 안전하고, Python에서는 스레드 안전하기도 해서 여러 스레드에서 불러도 됩니다. 다만 Python에서는 에이전트가 쉬고 있을 때 부르면 다음 호출이 취소되므로, 실행 중인 호출이 확실할 때만 부릅니다. TypeScript에서는 쉬고 있을 때의 agent.cancel() 호출은 아무 일도 하지 않습니다.
외부 신호는 Python에서 threading.Event를 __call__(), invoke_async(), stream_async()의 cancel_signal로 넘깁니다. 에이전트는 내부 신호와 외부 이벤트를 모두 지켜보므로 어느 쪽이든 독립적으로 취소를 일으키고, 호출자의 이벤트를 직접 설정하거나 해제하지 않습니다. 선언적인 시간 제한, 여러 에이전트에 신호 하나 공유하기, 클라이언트 연결이 끊길 때 프레임워크가 취소하기에 적합합니다. 비용은 두 가지입니다. 첫 체크포인트가 모델 스트리밍 안에 있어서, 호출 전에 이미 설정된 이벤트도 사용자 턴을 기록에 남기고 모델 요청을 한 번 보냈다가 중단할 수 있습니다. 또 에이전트는 이벤트를 폴링으로 확인하므로 최대 약 50ms 지연이 생기고, as_tool()로 중첩할 때마다 지연이 쌓입니다. 폴링 간격 안에서 설정했다가 해제한 이벤트는 놓치므로, 이벤트 해제는 호출과 호출 사이에서만 합니다.
신호는 모델 제공자에도 전달되어, 진행 중인 요청을 응답이 끝날 때까지 두지 않고 중단하게 합니다. 지원 여부는 제공자마다 다릅니다. Bedrock은 다음 청크 경계에서 스트리밍 응답을 닫지만, 아직 헤더를 돌려받지 못한 요청이나 streaming=False 호출은 중단하지 못합니다. 신호를 무시하는 제공자도 SDK의 청크 사이 체크포인트에서는 취소됩니다.
체크포인트는 도구 앞뒤에만 있으므로, 이미 시작된 도구의 취소는 협력 방식입니다. 도구가 스스로 멈추지 않으면 끝까지 실행된 뒤에야 에이전트가 취소 처리를 이어 갑니다. 기본 동시 실행기에서는 같은 응답에서 요청된 도구들이 이미 함께 실행 중일 수 있어서 이 점이 더 중요합니다. 오래 걸리는 도구는 tool_context.cancel_signal.is_set()을 단계 사이에 확인하거나, MCPClient.call_tool_async처럼 신호를 받는 API에 tool_context.cancel_signal을 넘깁니다. as_tool()로 도구가 된 에이전트는 부모의 신호를 자동으로 받으므로 부모를 취소하면 위임받은 에이전트도 취소됩니다.
import threading

from strands import Agent, tool
from strands.types.tools import ToolContext


@tool(context=True)
def normalize_records(records: list[str], tool_context: ToolContext) -> str:
    """Normalize records while checking for cancellation between items."""
    normalized = []
    for record in records:
        # 실행 중인 도구는 스스로 신호를 확인해야 일찍 멈춥니다.
        if tool_context.cancel_signal.is_set():
            return f"cancelled after {len(normalized)} records"
        normalized.append(record.strip().upper())
    return "\n".join(normalized)


agent = Agent(tools=[normalize_records], callback_handler=None)

cancel_signal = threading.Event()
deadline = threading.Timer(30.0, cancel_signal.set)  # 30초 시간 제한
deadline.start()

try:
    # 연결 종료 핸들러나 "중지" 버튼 핸들러에도 같은 이벤트를 넘기면 됩니다.
    result = agent(
        "Normalize these customer records: ' alice ', ' bob ', ' carol '",
        cancel_signal=cancel_signal,
    )
finally:
    deadline.cancel()

if result.stop_reason == "cancelled":
    print("Stopped by deadline or caller")
TypeScript에서는 AbortSignal을 cancelSignal 옵션으로 넘깁니다. 에이전트가 AbortSignal.any()로 내부 컨트롤러와 합치므로 agent.cancel()과 외부 신호가 각각 취소를 일으킵니다. AbortSignal.timeout(20_000)을 넘기면 20초 시한이 되고, 도구에서는 context.cancelSignal을 fetch 같은 API에 넘기거나 context.cancelSignal.aborted를 확인합니다.
취소는 에이전트를 완전히 멈춥니다. 사람의 입력을 기다렸다가 멈춘 지점에서 다시 이어 가는 인터럽트와 달리, 취소된 호출은 재개되지 않습니다.
동시 호출 모드와 멱등성 토큰
같은 에이전트 인스턴스로 요청이 동시에 들어오는 일은 생각보다 흔합니다. 재시도된 API 호출, 두 번 제출된 폼, 우연히 인스턴스를 공유한 두 웹 요청이 그렇습니다. 에이전트는 호출이 진행되는 동안 대화 기록을 바꾸므로, 겹친 호출이 메시지를 번갈아 쓰면 기록이 망가집니다. 그래서 기본으로는 한 번에 호출 하나만 처리하고 겹친 호출을 거부합니다.
Python에서는 생성자의 concurrent_invocation_mode가 이 동작을 정하고, ConcurrentInvocationMode 열거형의 THROW(기본값)나 UNSAFE_REENTRANT를 받습니다. 기본 THROW 모드에서 이미 실행 중인 에이전트를 호출하면 ConcurrencyException이 발생합니다. 인스턴스 하나가 대화 하나에 대응하는 대부분의 애플리케이션에는 이 동작이 맞습니다.
거부만으로 부족한 경우가 있습니다. 아직 실행 중인 요청의 재시도가 도착했을 때는 오류를 내거나 같은 작업을 두 번 하는 것보다 원래 호출의 결과를 돌려주는 편이 낫습니다. 멱등성 토큰(idempotency token)이 이 문제를 풉니다. 모든 호출 메서드(__call__, invoke_async, stream_async)에 idempotency_token을 넘겨 논리적 요청을 식별하면, 같은 토큰으로 이미 진행 중인 호출이 있을 때 새 호출은 원래 호출을 기다렸다가 같은 AgentResult를 반환합니다. 토큰은 동등성으로 비교하므로 주문 ID, 요청 UUID, 프롬프트 문자열처럼 안정적인 식별자면 무엇이든 됩니다. 토큰이 다르면 중복 제거가 적용되지 않고 여전히 ConcurrencyException이 발생합니다.
중복 제거된 호출은 최종 결과만 받고 원래 호출의 스트리밍 이벤트는 받지 못합니다. 대신 그 호출의 callback_handler가 결과와 함께 한 번 호출되므로 출력 소비자가 빈손으로 남지는 않습니다. 원래 호출이 결과 없이 끝나면, 예를 들어 도중에 취소되면, 기다리던 호출에서는 IdempotencyAbortedError가 발생하고 다시 시도할지는 호출자가 정합니다.
from strands import Agent
from strands.types.exceptions import ConcurrencyException, IdempotencyAbortedError

agent = Agent(callback_handler=None)


def process_order(order_id: str):
    try:
        # 같은 주문의 재시도는 진행 중인 원래 호출의 결과를 그대로 받습니다.
        return agent(f"Process order {order_id}", idempotency_token=f"order-{order_id}")
    except IdempotencyAbortedError:
        # 원래 호출이 결과 없이 끝났습니다(예: 취소). 재시도 여부를 여기서 정합니다.
        return None
    except ConcurrencyException:
        # 토큰이 다른 호출이 이 인스턴스에서 실행 중입니다.
        raise
UNSAFE_REENTRANT는 단일 호출 보호 장치를 통째로 없앱니다. 두 모드의 차이는 다음과 같습니다.
| 상황 | THROW(기본값) |
UNSAFE_REENTRANT |
|---|---|---|
| 실행 중에 토큰 없이 호출 | ConcurrencyException이 발생합니다. |
그대로 함께 실행됩니다. |
| 실행 중에 같은 토큰으로 호출 | 원래 호출을 기다렸다가 같은 결과를 반환합니다. | 토큰을 무시하고 함께 실행됩니다. |
| 실행 중에 다른 토큰으로 호출 | ConcurrencyException이 발생합니다. |
그대로 함께 실행됩니다. |
| 대화 기록 보호 | 겹친 변경이 일어나지 않습니다. | 보호하지 않아서 기록이 망가질 수 있습니다. |
UNSAFE_REENTRANT 모드는 Agent(concurrent_invocation_mode=ConcurrentInvocationMode.UNSAFE_REENTRANT)처럼 켜며, 열거형은 strands.types.agent에서 가져옵니다. 호출마다 격리된 상태만 다루거나 동기화를 직접 처리할 때만 씁니다. TypeScript는 겹친 호출에 ConcurrentInvocationError를 던지고, 동시성 모드 설정과 멱등성 토큰 중복 제거는 Python SDK에만 있습니다.
서로 독립적인 작업을 병렬로 돌리려면 인스턴스 하나를 공유하기보다 작업마다 에이전트를 따로 두는 편이 안전합니다. 동시 요청이 많은 서비스라면 요청마다 새 에이전트를 만들어 두 요청이 인스턴스를 공유하지 않게 하는 방식을 권장합니다. 이렇게 하면 동시성 보호 장치에 걸릴 일이 없고, 앞서 설명한 턴·토큰 제한과 취소 신호를 요청마다 따로 걸 수 있습니다. 다만 이런 무상태 방식은 인터럽트를 재개하지 못합니다. 사람의 입력이 필요한 애플리케이션은 에이전트나 세션 상태, 반환된 인터럽트 ID를 따로 보존해야 합니다.
여러 에이전트 조율하기
에이전트 하나에 모든 도구와 지시를 몰아넣으면 시스템 프롬프트가 길어지고 모델이 고를 도구도 많아집니다. 역할별로 에이전트를 나누면 각 에이전트는 좁은 영역에 집중합니다. 전문 에이전트는 따로 추가하거나 빼거나 조정할 수 있습니다. Strands에서 에이전트를 조합하는 방법은 크게 세 가지입니다.
- 한 에이전트를 다른 에이전트의 도구로 넘기는 방법
- 별도 서비스로 실행되는 에이전트를 Agent-to-Agent(A2A) 프로토콜로 연결하는 방법
- Graph·Swarm·Workflow로 구조화해 조율하는 방법
어느 방법이든 가장 작은 실행 단위는 Strands Agent 하나이며, 에이전트들이 정보를 주고받으면서 최종 답에 다가갑니다.
도구로서의 에이전트
가장 작은 다중 에이전트 시스템은 전문 에이전트를 오케스트레이터의 tools에 그대로 넣는 형태입니다. SDK는 이 에이전트를 input 문자열 하나를 받아 에이전트의 텍스트 응답을 돌려주는 도구로 자동 변환합니다. 오케스트레이터 모델은 다른 도구와 똑같이 이름과 설명을 읽고, 질의가 맞으면 호출합니다. 위임 여부는 모델이 정합니다. 그러니 설명에는 그 에이전트의 전문 영역을 분명히 드러내고, 오케스트레이터의 시스템 프롬프트에는 어떤 질문을 어느 에이전트로 보낼지 기준을 적어 둡니다.
전문 에이전트에는 callback_handler=None을 줍니다. 이 설정이 없으면 전문 에이전트의 기본 핸들러도 자기 응답을 콘솔에 출력해서, 위임할 때마다 같은 텍스트가 두 번 나옵니다. 도구 이름이나 설명을 바꾸려면 .as_tool()을 명시적으로 씁니다.
from pydantic import BaseModel
from strands import Agent
from strands.vended_tools import http_request

research_agent = Agent(
    system_prompt="""You are a specialized research assistant. Focus only on providing
    factual, well-sourced information in response to research questions.""",
    tools=[http_request],
    callback_handler=None,  # 콘솔 출력은 오케스트레이터만 합니다.
)


class BillingResponse(BaseModel):
    summary: str
    refund_amount: float


billing_agent = Agent(
    name="billing_expert",
    description="Answers billing questions: charges, refunds, and invoices.",
    system_prompt="You handle billing questions with precision.",
    structured_output_model=BillingResponse,
    callback_handler=None,
)

orchestrator = Agent(
    system_prompt="""Route research questions to research_assistant and
billing questions to billing_expert. Answer general questions yourself.""",
    tools=[
        research_agent.as_tool(
            name="research_assistant",
            description="Process and respond to research-related queries requiring factual information.",
        ),
        # 위임: 결제 에이전트의 응답을 오케스트레이터가 다시 다듬지 않고 그대로 반환합니다.
        billing_agent.as_tool(delegate=True),
    ],
)

result = orchestrator("Why was I charged twice?")
직접 넘기든 .as_tool()을 쓰든, 기본 동작은 호출할 때마다 전문 에이전트의 대화 맥락을 초기화하는 것입니다. 그래서 매번 깨끗한 상태에서 시작합니다. 같은 오케스트레이터 세션 안에서 이전 상호작용을 기억하게 하려면 as_tool(preserve_context=True)를 씁니다. 이 설정은 하위 에이전트의 인터럽트가 어디서 재개를 기다릴지도 정합니다. False이면 오케스트레이터가 중단된 턴을 저장하므로 재시작 뒤에도 재개됩니다. True이면 하위 에이전트가 자기 상태를 들고 있으므로 그 에이전트에 별도 세션 매니저를 붙여야 합니다.
delegate=True는 하위 에이전트의 응답을 오케스트레이터가 다시 처리할 이유가 없을 때 씁니다. 생성된 소스 코드, 규정 검토를 거친 고객 응대 문구, 호출자가 바로 소비하는 구조화 데이터가 그런 예입니다. 오케스트레이터 모델 왕복이 한 번 줄어 토큰을 아끼고, 응답이 바뀔 위험도 없어집니다. 성공하면 루프는 end_turn으로 끝나고 AgentResult에 위임 대상의 내용이 그대로 담깁니다. 위임 대상의 스트리밍 이벤트는 부모 스트림에 그대로 나타납니다.
제약은 둘입니다. 첫째, 한 턴에 위임 도구를 호출하면 그 도구만 단독으로 호출해야 합니다. 다른 도구가 함께 요청되면 SDK가 도구 묶음을 취소합니다. 둘째, 위임은 루프를 일찍 빠져나가므로 대화 상태를 서버 쪽에서 관리하는 상태 저장형 모델과는 함께 쓸 수 없습니다.
전처리·후처리, 오류 처리, 매개변수 여러 개가 필요하면 @tool 함수 안에서 에이전트를 만들어 호출하는 사용자 정의 도구로 감쌉니다. 원격 A2A 에이전트도 A2AAgent 클래스로 같은 방식의 도구가 됩니다.
Graph, Swarm, Workflow: 실행 경로를 누가 정하는가
구조화된 조율이 필요할 때 세 패턴 중 무엇을 고를지 가르는 가장 큰 기준은 실행 경로를 정하는 주체입니다. Graph와 Swarm은 SDK에 내장된 오케스트레이터이고, Workflow는 에이전트를 코드로 엮어 구현하는 패턴입니다.
| 구분 | Graph | Swarm | Workflow |
|---|---|---|---|
| 핵심 개념 | 개발자가 정의한 흐름도 위에서 에이전트가 경로 선택 | 에이전트들이 스스로 작업을 넘기는 협업 팀 | 대화 없는 단일 도구로 실행되는 사전 정의 작업 그래프(DAG) |
| 구조 정의 | 개발자가 노드와 엣지를 모두 미리 정의 | 개발자는 에이전트 풀만 제공, 경로는 에이전트가 결정 | 개발자가 작업과 의존 관계를 코드로 정의 |
| 실행 흐름 | 엣지를 따르되 노드마다 LLM 판단으로 경로 결정 | 순차적·자율적, 작업 후 가장 적합한 동료에게 제어권 이양 | 의존 그래프로 고정된 결정적 흐름, 독립 작업은 병렬 실행 |
| 순환 허용 | 허용 | 허용 | 불허 |
| 상태 공유 | 모든 에이전트가 읽고 고치는 공유 상태 객체 | 원래 요청, 작업 이력, 앞선 에이전트의 지식을 담은 공유 컨텍스트 | 작업 출력이 의존 작업의 입력으로 자동 전달 |
| 대화 기록 | 공유 상태에 포함된 전체 대화 기록 | 이양 이력과 앞선 에이전트 기여를 담은 공유 기록 | 의존 작업 결과만 추린 작업별 컨텍스트 |
| 사용자 영향 | 단계마다 입력이 다음 경로를 직접 좌우 | 첫 프롬프트로 목표만 정하고 이후 자율 실행 | 프롬프트로 실행을 시작할 뿐 내부 구조는 불변 |
| 오류 처리 | 명시적 오류 엣지로 오류 처리 노드에 라우팅 | 오류 처리 전문가에게 이양, 무한 루프는 타임아웃과 이양 횟수 제한으로 방지 | 한 작업 실패 시 하위 의존 작업 전체 중단 |
| 적합한 작업 | 의도별 고객 지원 라우팅, 오류 경로가 있는 데이터 검증 | 장애 대응처럼 경로가 상황에 따라 드러나는 다분야 협업 | 데이터 파이프라인, 직원 온보딩 같은 반복 업무 |
Graph는 다음 단계가 현재 단계의 결과로 정해지는 업무 절차에 맞습니다. Python에서는 GraphBuilder로 노드, 엣지, 진입점을 정의하고 build()로 그래프를 만듭니다. 진입점 노드는 원래 작업을 입력으로 받습니다. 의존 노드는 원래 작업과 완료된 의존 노드들의 결과를 합친 입력을 받습니다. 엣지 조건 함수가 invocation_state를 키워드 인자로 받으면 기능 플래그나 사용자 역할 같은 실행 시점 문맥으로 경로를 고릅니다. 이 조건은 현재 Python SDK에만 있습니다.
from strands import Agent
from strands.multiagent import GraphBuilder
from strands.multiagent.graph import GraphState

researcher = Agent(name="researcher", system_prompt="You are a research specialist...")
analyst = Agent(name="analyst", system_prompt="You are a data analysis specialist...")
fact_checker = Agent(name="fact_checker", system_prompt="You are a fact checking specialist...")
report_writer = Agent(name="report_writer", system_prompt="You are a report writing specialist...")


def strict_mode(state: GraphState, *, invocation_state: dict, **kwargs) -> bool:
    """Only run fact checking when the caller asks for it."""
    return invocation_state.get("strict_mode", False)


builder = GraphBuilder()
builder.add_node(researcher, "research")
builder.add_node(analyst, "analysis")
builder.add_node(fact_checker, "fact_check")
builder.add_node(report_writer, "report")

builder.add_edge("research", "analysis")
builder.add_edge("research", "fact_check", condition=strict_mode)
builder.add_edge("analysis", "report")
builder.add_edge("fact_check", "report")

builder.set_entry_point("research")
builder.set_execution_timeout(600)  # 10분 시간 제한

graph = builder.build()
result = graph(
    "Research the impact of AI on healthcare and create a comprehensive report",
    invocation_state={"strict_mode": True},
)

print(f"Status: {result.status}")
print(f"Execution order: {[node.node_id for node in result.execution_order]}")
report처럼 들어오는 엣지가 여럿인 합류 노드는 언어마다 다르게 동작합니다. Python은 OR 의미론이어서, 완료된 배치에서 들어오는 엣지 하나만 충족돼도 노드가 실행됩니다. 실행은 배치 단위이고, 배치 전체가 끝나야 다음 노드들을 스케줄합니다. TypeScript는 AND 의미론이어서, 들어오는 엣지의 출발 노드가 모두 끝나야 실행됩니다. 준비된 노드는 maxConcurrency까지 하나씩 바로 띄웁니다.
오류 처리도 반대입니다. Python에서는 노드 실패가 예외를 던지고, 오케스트레이터 수준 제한 위반은 FAILED 결과를 돌려줍니다. TypeScript에서는 노드 실패가 FAILED 결과가 되어 병렬 경로가 계속 진행되고, maxSteps 같은 전역 제한은 예외를 던집니다. 순환 그래프에서 같은 노드를 다시 방문하면, Python은 reset_on_revisit을 켜지 않는 한 에이전트 상태가 누적됩니다. TypeScript 에이전트 노드는 기본적으로 상태가 없습니다. 같은 그래프 정의라도 언어를 옮기면 결과가 달라질 수 있으므로 합류 지점과 실패 경로는 대상 언어 기준으로 확인합니다.
Graph의 노드에는 Swarm이나 다른 Graph를 그대로 넣을 수 있고, A2AAgent로 원격 에이전트를 노드로 쓸 수도 있습니다. 검증처럼 LLM 판단이 필요 없는 단계는 Python에서 MultiAgentBase를 상속한 사용자 정의 노드로 만들어 모델 호출 없이 결정적으로 처리합니다. 예를 들어 연구 단계는 Swarm에 맡겨 자율적으로 탐색하게 하고, 그 결과를 Graph의 고정된 분석 단계로 넘길 수 있습니다.
공유 상태
Graph와 Swarm은 모두 invocation_state로 모든 에이전트에 상태를 넘깁니다. 같은 딕셔너리를 graph(..., invocation_state=shared_state)에도 swarm(..., invocation_state=shared_state)에도 그대로 씁니다. 이 값은 다음 대상에 자동으로 전파되고, 프롬프트에는 나타나지 않습니다.
- 패턴 안의 모든 에이전트
@tool(context=True)로 선언한 도구의ToolContextBeforeToolCallEvent와AfterToolCallEvent훅
사용자 ID, 세션 ID, 디버그 플래그, 데이터베이스 연결 객체처럼 모델이 볼 필요가 없는 문맥과 구성을 여기에 담습니다. Graph에서는 앞서 본 조건 엣지에도 이 값이 전달됩니다. 인터럽트와 재개 사이클에서도 그래프 체크포인트와 함께 직렬화되어 유지됩니다.
TypeScript에서는 invoke()나 stream()의 두 번째 인자에 invocationState를 넘깁니다. 이 값은 참조로 공유되는 변경 가능한 Record<string, unknown>이어서, 한 노드의 훅이나 도구가 쓴 값을 다음 노드가 읽습니다. 여기에 더해 오케스트레이터의 MultiAgentState가 모든 노드에 공유됩니다. MultiAgentState가 제공하는 항목은 다음과 같습니다.
results: 완료 순서대로 쌓인 결과- 노드별 상태:
state.node(id)로 조회 steps: 지금까지의 노드 실행 수app: 훅·엣지 핸들러·사용자 정의 노드가 함께 쓰는 키-값 저장소
핵심은 두 경로를 구분해서 쓰는 것입니다. 공유 상태는 프롬프트에 드러나면 안 되는 문맥과 구성을 위한 통로입니다. 모델이 추론해야 할 데이터는 Swarm의 공유 컨텍스트나 Graph의 노드 입력처럼 각 패턴의 데이터 흐름으로 전달합니다. 모델이 판단에 써야 할 정보를 invocation_state에만 넣으면 모델은 그 정보를 보지 못합니다.
프로덕션 운영 구성
실제 트래픽을 받는 에이전트에는 개발 때 없던 요구가 생깁니다. 에이전트가 닿을 수 있는 도구를 막아 두어야 하고, 실행 시간과 비용에 상한을 두어야 하며, 실패해도 처리하지 않은 예외가 호출자에게 그대로 전달되지 않게 해야 합니다. 출발점은 기본값에 기대지 않고 설정을 모두 명시적으로 고정하는 것입니다.
모델과 도구를 명시적으로 고정하기
모델은 원하는 속성을 직접 지정한 객체로 넘깁니다. model_id, temperature, top_p와 함께 응답 하나의 길이를 묶는 max_tokens까지 정해 두어, 기본값에 기대지 않고 모델과 생성 설정을 고정합니다.
도구 관리 원칙은 셋입니다.
- 도구 목록을 명시합니다. 쓸 수 있는 도구를 모두 불러오지 말고, 필요한 도구만 담은 목록을
tools로 넘깁니다. - 자동 로딩을 꺼 둔 상태로 유지합니다. 디렉터리에서 도구를 자동으로 불러오고 다시 불러오는 기능은 기본으로 꺼져 있습니다(
load_tools_from_directory=False). 프로덕션 안정성을 위해 이 기본값을 그대로 둡니다. - 도구 사용을 주기적으로 점검합니다. 실제로 어떤 도구가 쓰이는지 검토하고, 이 사용 사례에 필요 없는 도구는 뺍니다.
보안: 최소 권한, 입력 검증, 출력 정제
직접 작성한 도구든 SDK에 포함된 도구든, 모든 도구는 호스트 프로세스의 권한으로 코드를 실행합니다. 공동 책임 모델(shared responsibility model)에 따라 각 도구의 파일 접근, 네트워크 호출, 셸 실행을 감사하고 배포 환경과 위협 모델에 맞는지 확인하는 일은 사용자의 몫입니다. 프로덕션에서는 다음 세 가지를 지킵니다.
- 도구 권한: 도구마다 권한을 검토해 최소 권한 원칙에 맞게 제한합니다.
- 입력 검증: 사용자 입력은 에이전트에 넘기기 전에 항상 검증합니다.
- 출력 정제: 출력에서 민감한 정보를 걸러 내고, 자동화 수단으로 가드레일(guardrails)을 씁니다.
목록을 좁히는 일과 권한을 좁히는 일은 서로를 보완합니다. 목록에서 뺀 도구는 모델이 아예 고를 수 없고, 남은 도구는 권한이 좁아서 잘못 호출되어도 피해 범위가 작습니다.
실행 한도: 네 가지 차원
모든 프로덕션 에이전트에는 명시적인 실행 경계가 있어야 합니다. 한도는 요청의 서비스 수준 목표와 비용 예산에 맞춰 정하고, 기준선은 서로 독립적인 네 차원으로 잡습니다.
| 차원 | 수단 | 이 수단만으로 막지 못하는 것 |
|---|---|---|
| 루프 반복 | 호출마다 limits로 정하는 턴 수 제한 |
느린 도구 하나의 실행 시간 |
| 도구 호출 | 비용이 크거나 속도 제한·부수 효과가 있는 도구에 거는 훅 기반 호출 횟수 한도 | 다른 도구와 모델 호출의 비용 |
| 토큰 소비 | 호출 단위 전체·출력 토큰 제한과 모델의 max_tokens |
경과 시간 |
| 경과 시간 | 호출 바깥의 시한과 시한 만료 시 에이전트 취소 | 예측 가능한 토큰 예산 |
호출 단위 토큰 제한은 턴 사이에 검사하므로, 모델 호출 한 번이 설정한 전체 한도를 넘긴 뒤에야 루프가 멈출 수 있습니다. 이 한 턴 분량의 초과는 모델의 max_tokens로 묶습니다. 도구 호출 한도는 Limit Tool Counts 훅 패턴을 쓰며, 이 패턴은 호출마다 횟수를 초기화합니다. 경과 시간은 Python에서 감시 타이머가 agent.cancel()을 부르고, TypeScript에서는 invoke()나 stream()에 cancelSignal(예: AbortSignal.timeout(30_000))을 넘기거나 agent.cancel()을 부릅니다. 도구 안에서 이미 실행 중인 작업은 협조적으로 취소되므로, 같은 시한을 하위 네트워크 호출과 블로킹 작업에도 전달합니다.
경계는 하나만 두지 않습니다. 턴 제한은 느린 도구 하나를 막지 못하고, 시간 제한만으로는 토큰 예산을 예측할 수 없습니다. 다중 에이전트 시스템에서는 오케스트레이터와 노드 양쪽에 한도를 겁니다. Swarm은 Python에서 이양·반복 횟수와 전체·노드별 실행 시간을 제한하고, TypeScript에서는 maxSteps, timeout, nodeTimeout을 씁니다. Graph도 전체 노드 실행 횟수와 전체·노드별 실행 시간을 제한하며, 설정 이름은 SDK마다 다릅니다.
한도는 한 번 정하고 끝내지 않습니다. 배포한 뒤에는 각 한도에 얼마나 자주 도달하는지 지켜보며 조정합니다. 결과의 종료 이유를 한도별로 따로 기록해 집계하는 방식을 권장합니다. 정상적인 요청이 특정 한도에 자주 걸리면 그 한도가 서비스 목표에 비해 빡빡하다는 신호이니 해당 차원만 늘리고, 거의 걸리지 않는 한도는 비용 예산 쪽으로 좁힙니다. 차원별로 따로 세어야 어느 경계를 움직일지 정할 수 있습니다.
오류 처리와 스트리밍 응답
오류는 명시적으로 처리합니다. 예외가 호출자에게 전파되게 두지 말고, 실패를 로그로 남긴 뒤 대체 응답으로 넘어갑니다. 한도 소진은 일반 오류가 아니라 예상된 결과로 다루며, 예외 처리와 별도로 종료 이유를 보고 분기합니다.
응답성을 위해서는 stream_async()로 응답을 스트리밍합니다. 내용이 생성되는 대로 호출자에게 보내므로 체감 지연이 줄어듭니다. 웹 애플리케이션에서는 이벤트 중 data가 있는 것만 골라 내보내는 비동기 제너레이터가 기본 형태입니다.
아래 예제는 모델·도구·대화 관리 설정과 시한, 오류 처리를 한곳에 모은 것입니다. 시한은 예시 값이므로 서비스 목표에 맞게 바꿉니다. 동기 경로와 스트리밍 경로 모두 같은 감시 타이머로 시한을 겁니다. 에이전트를 요청마다 새로 만드므로, 타이머가 호출이 끝난 직후에 발동해도 다른 요청에는 영향이 없습니다.
import logging
import threading

from strands import Agent, tool
from strands.agent.conversation_manager import SlidingWindowConversationManager
from strands.models import BedrockModel

logger = logging.getLogger(__name__)

# 예시 값입니다. 서비스 목표와 비용 예산에 맞춰 정합니다.
DEADLINE_SECONDS = 30.0
FALLBACK_TEXT = "The request could not be completed. Please try again later."
TIMEOUT_NOTICE = "\n[Response stopped: time limit reached]"


@tool
def get_weather(city: str) -> str:
    """Get the current weather for a city."""
    return f"It's sunny in {city}."


def build_agent() -> Agent:
    # 기본값에 기대지 않고 모델 설정을 모두 고정합니다.
    model = BedrockModel(
        model_id="us.amazon.nova-premier-v1:0",
        temperature=0.3,
        max_tokens=2000,  # 응답 하나의 길이 상한
        top_p=0.8,
    )
    return Agent(
        model=model,
        tools=[get_weather],  # 필요한 도구만 명시합니다. 자동 로딩은 기본으로 꺼져 있습니다.
        conversation_manager=SlidingWindowConversationManager(window_size=10),
    )


def start_watchdog(agent: Agent) -> tuple[threading.Timer, threading.Event]:
    """Cancel the agent when the deadline passes and remember that it fired."""
    timed_out = threading.Event()

    def on_deadline() -> None:
        timed_out.set()
        agent.cancel()

    watchdog = threading.Timer(DEADLINE_SECONDS, on_deadline)
    watchdog.start()
    return watchdog, timed_out


def run_task(prompt: str) -> str:
    agent = build_agent()
    watchdog, timed_out = start_watchdog(agent)
    try:
        result = agent(prompt)
    except Exception as e:
        # 예외를 호출자에게 그대로 넘기지 않고 기록한 뒤 대체 응답을 돌려줍니다.
        logger.error(f"Agent error: {str(e)}")
        return FALLBACK_TEXT
    finally:
        watchdog.cancel()

    if timed_out.is_set():
        # 시한 도달은 예상된 결과입니다. 기록해 도달 빈도를 집계합니다.
        logger.warning("Execution boundary reached: deadline")
    return str(result)


async def stream_agent_response(prompt: str):
    agent = build_agent()
    watchdog, timed_out = start_watchdog(agent)  # 스트리밍 경로에도 같은 시한을 겁니다.
    try:
        async for event in agent.stream_async(prompt):
            if "data" in event:
                yield event["data"]
    except Exception as e:
        logger.error(f"Agent error: {str(e)}")
        yield FALLBACK_TEXT
    finally:
        watchdog.cancel()

    if timed_out.is_set():
        # 이미 보낸 부분 텍스트 뒤에 중단 사실을 알립니다.
        logger.warning("Execution boundary reached: deadline")
        yield TIMEOUT_NOTICE
턴·토큰 한도는 호출마다 limits로 넘기며, 구체적인 설정 방법은 Invocation Limits 문서를 따릅니다.
스트리밍에서는 오류나 시한 초과가 응답 도중에 일어납니다. 일부 텍스트를 이미 보낸 뒤에 대체 문구나 중단 안내가 이어 붙을 수 있으므로, UI는 이 경우를 따로 표시하도록 설계합니다. 슬라이딩 윈도우 매니저는 window_size로 대화 기록 크기를 적정 수준으로 유지해, 컨텍스트 윈도우 초과 예외를 막는 데 도움이 됩니다.
배포 대상과 관측 가능성
개발 때 만든 에이전트를 그대로 배포합니다. 루프, 도구, 모델 제공자는 바뀌지 않고 배포 대상마다 감싸는 패키징만 달라집니다. 대부분의 대상은 HTTP로 호출 경로에 요청을 보내고, 헬스 경로로 컨테이너가 살아 있는지 확인합니다.
from fastapi import FastAPI
from strands import Agent

app = FastAPI()


@app.post("/invocations")
async def invoke(request: dict):
    # 요청마다 에이전트를 새로 만들어 동시 요청이 한 인스턴스에 몰리지 않게 합니다.
    agent = Agent()
    result = await agent.invoke_async(request["prompt"])
    return {"output": result.message}


@app.get("/ping")
def ping():
    return {"status": "healthy"}
모듈 수준에서 에이전트 하나를 공유하면 호출 방식에 따라 다른 문제가 생깁니다. invoke_async로 부르면 요청이 겹칠 때 앞서 설명한 동시 호출 모드의 기본값 THROW 때문에 뒤에 온 요청이 ConcurrencyException으로 끝납니다. async def 핸들러 안에서 동기 agent(...)로 부르면 예외는 나지 않지만 이벤트 루프가 막혀 같은 프로세스의 요청이 하나씩 차례로 처리됩니다. 어느 쪽이든 앞 요청의 대화 기록이 다음 요청에 그대로 이어지므로, 실제 서비스에서는 위처럼 요청마다 에이전트를 만들고 비동기 핸들러에서는 invoke_async를 씁니다.
| 배포 대상 | 성격 | 적합한 경우 |
|---|---|---|
| Amazon Bedrock AgentCore | 에이전트용 관리형 서버리스 런타임 | 에이전트와 도구의 안전한 배포·확장 |
| AWS Lambda | 서버 관리가 없는 이벤트 기반 서버리스 | 짧은 상호작용과 배치 처리 |
| AWS Fargate | 호스트 프로비저닝 없는 ECS 컨테이너 실행 | 스트리밍·높은 동시성·고가용성 요구 |
| AWS App Runner | 배포·확장·부하 분산을 자동화한 컨테이너 웹 서비스 | 실시간 응답이 필요한 대화형 애플리케이션 |
| Amazon EKS | 관리형 Kubernetes | 클러스터 제어 요구 |
| Amazon EC2 | 직접 관리하는 인스턴스 | 대용량 처리·특수한 인프라 요구 |
배포가 처음이라면 Docker로 로컬에서 컨테이너를 만든 뒤 클라우드 대상으로 옮깁니다. 공식 Lambda 배포 예제는 응답 스트리밍을 구현하지 않으므로, 스트리밍이 필요하면 Fargate가 맞습니다. Lambda 함수 역할이나 Fargate 작업 역할에는 앞서 설명한 Bedrock 호출 권한을 붙입니다. Lambda에서 MCP 도구를 쓸 때는 호출마다 컨텍스트 매니저로 연결을 새로 엽니다. 웜 호출 사이에 연결을 재사용하면 사용자 사이에 상태가 새어 나갈 수 있으므로 테넌시 모델을 검토한 뒤에만 적용합니다.
CPU나 메모리만으로는 에이전트가 무엇을 했는지 알 수 없으므로 추론 과정을 함께 기록합니다. 메트릭은 설정 없이 result.metrics.get_summary()에서 얻습니다. total_cycles(루프 사이클 수), accumulated_usage(누적 토큰), tool_usage(도구별 호출 횟수·성공 횟수·평균 소요 시간)를 호출마다 남기고, 앞서 설명한 종료 이유 집계와 함께 대시보드에 올립니다. 트레이스는 익스포터를 설정해야 나옵니다. StrandsTelemetry로 OpenTelemetry SDK를 연결하고 setup_console_exporter()나 setup_otlp_exporter()로 익스포터를 지정하면, 이후 만드는 모든 에이전트에 계측이 자동으로 붙습니다. 루프 코드를 직접 감싸지 않아도 사이클·모델 호출·도구 실행의 스팬 계층을 Jaeger나 CloudWatch 같은 OTEL 백엔드에서 볼 수 있습니다.
Sources
- Python Quickstart | Strands Agents
- Get started | Strands Agents
- TypeScript Quickstart | Strands Agents
- Agent Loop | Strands Agents
- Hooks | Strands Agents
- Retry Strategies | Strands Agents
- Conversation Management | Strands Agents
- Production Lifecycle Controls | Strands Agents
- Hook events | Strands Agents
- Steering | Strands Agents
- Interventions | Strands Agents
- Middleware | Strands Agents
- Add tools to your agent | Strands Agents
- Attach and invoke tools | Strands Agents
- Create custom tools | Strands Agents
- Connect your agent to MCP tools | Strands Agents
- Vended Tools | Strands Agents
- Community tools package | Strands Agents
- Tool Executors | Strands Agents
- MCP Transports | Strands Agents
- Tool result format | Strands Agents
- Coordinate multiple agents | Strands Agents
- Agents as tools | Strands Agents
- Agent-to-Agent (A2A) Protocol | Strands Agents
- Graph Multi-Agent Pattern | Strands Agents
- Agent Workflows: Building Multi-Agent Systems with Strands Agents SDK | Strands Agents
- A2A Server Configuration | Strands Agents
- Graph Components | Strands Agents
- Amazon Bedrock | Strands Agents
- Bedrock Prompt Caching | Strands Agents
- OpenAI Responses API | Strands Agents
- Amazon Nova | Strands Agents
- Google | Strands Agents
- Vercel | Strands Agents
- OpenAI | Strands Agents
- Writer | Strands Agents
- Anthropic | Strands Agents
- Operating Agents in Production | Strands Agents
- Deploying Strands Agents SDK Agents to AWS Lambda | Strands Agents
- Deploying Strands Agents SDK Agents to AWS Fargate | Strands Agents
- Deploying Strands Agents SDK Agents to AWS App Runner | Strands Agents
- Deploying Strands Agents SDK Agents to Amazon EKS | Strands Agents
- Deploying Strands Agents SDK Agents to Amazon EC2 | Strands Agents
- Deploy to Kubernetes | Strands Agents
- Deploy to production | Strands Agents
- Lesson 1: How agents really work | Strands Agents
- strands.event_loop.event_loop | Strands Agents
- strands.models.model | Strands Agents
- strands.types.streaming | Strands Agents
- Observability for AI Agents with OpenTelemetry | AWS Builder Center
- Tool simulation | Strands Agents
- Structured output | Strands Agents
- Customizing user simulation | Strands Agents
- Strands Agents | Open source SDK for AI agents in Python and TypeScript
Subscribe via RSS