ToolOrchestra: Elevating Intelligence via Efficient Model and Tool Orchestration
ToolOrchestra: 효율적인 모델·도구 오케스트레이션으로 지능을 끌어올리기
Paper by NVIDIA
Cover: Herbig-Haro 46/47, NASA, ESA, CSA, J. DePasquale (STScI) (CC BY 4.0)
Contents
TL;DR
ToolOrchestra는 80억 파라미터의 작은 모델을 오케스트레이터로 강화학습시키는 방법입니다. 이 모델은 웹 검색이나 코드 인터프리터 같은 도구뿐 아니라 GPT-5 같은 더 강한 모델까지 도구로 불러 씁니다. 보상에는 최종 정답 여부, 비용과 지연 시간, 사용자의 도구 선호가 함께 들어갑니다. 그 결과 Orchestrator-8B는 HLE에서 37.1%를 기록해 GPT-5(35.1%)를 앞섰고, 효율은 2.5배 높았습니다.
🔍 이 연구는 왜 필요합니까?
기존 도구 사용 에이전트는 대개 강한 모델 하나에 검색기나 계산기 같은 유틸리티 도구를 붙이는 구조입니다. 저자들은 사람이 전문가나 정교한 소프트웨어를 불러 자신의 한계를 넘듯이, 모델도 자신보다 강하거나 약한 여러 모델을 "지능형 도구"로 쓸 수 있어야 한다고 봅니다. 문제는 도구마다 비용이 다르다는 점입니다. 오케스트레이터는 비용과 사용자 선호를 고려하면서 어떤 도구를 어떤 순서로 부를지 동적으로 정해야 합니다.
가장 단순한 방법은 기성 LLM에 프롬프트로 이 역할을 맡기는 것입니다. 그런데 이 방식에는 체계적인 편향이 있습니다. 비용을 아끼라고 지시해도 GPT-5는 자기 계열인 GPT-5-mini에 호출의 66%를 몰아줍니다. 반대로 Qwen3-8B는 호출의 73%를 가장 강한 GPT-5에 넘깁니다.
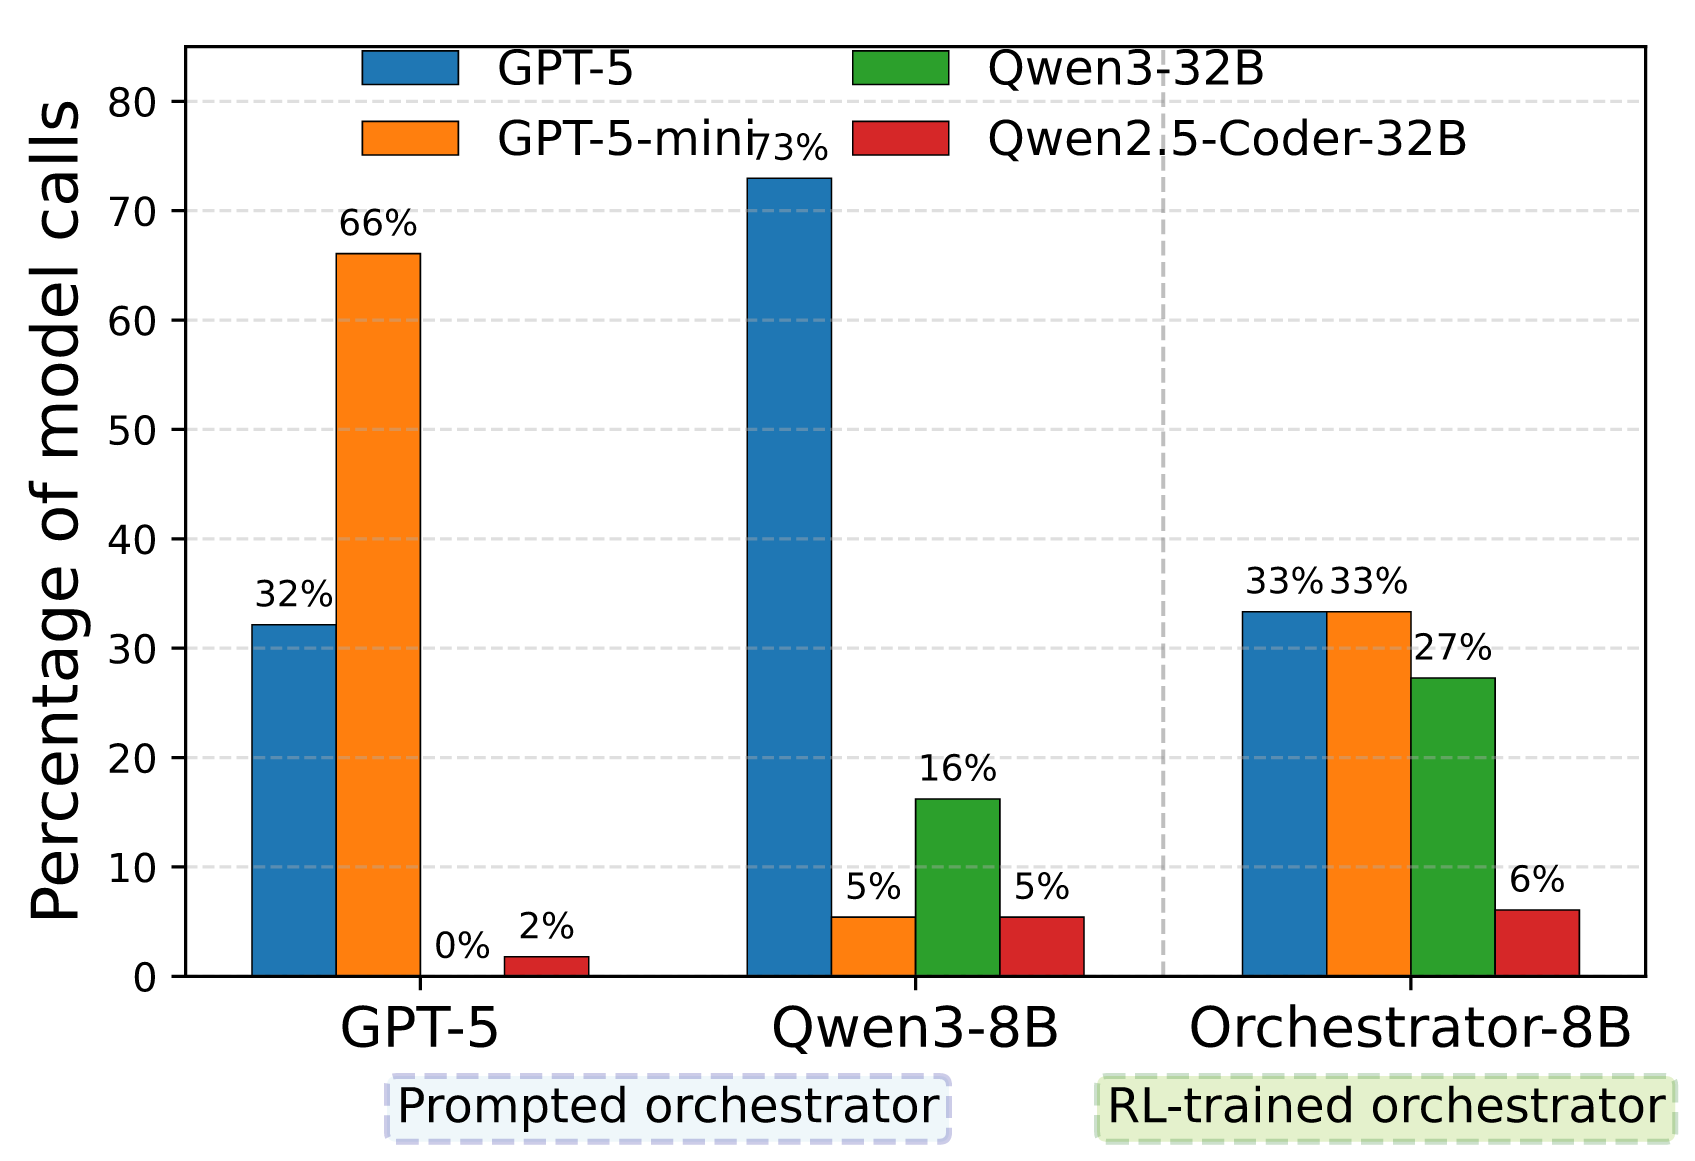
이 그래프에서는 프롬프트 기반 두 모델이 특정 모델 하나에 호출을 몰아주는 모습을 보면 됩니다. 반면 학습된 Orchestrator-8B는 GPT-5 33%, GPT-5-mini 33%, Qwen3-32B 27%로 호출을 고르게 나눕니다. 저자들은 이런 편향 때문에 오케스트레이션 전용 학습이 필요하다고 주장합니다. 또한 비용 효율과 사용자 선호라는 두 가지 제어 축이 지금까지 거의 다뤄지지 않았다고 지적합니다.
💡 어떤 해결책을 제시합니까?
핵심은 작은 모델(Qwen3-8B 기반)을 이질적인 도구 집합의 "두뇌"로 두고, 강화학습으로 끝까지(end-to-end) 학습시키는 것입니다. 도구는 세 부류입니다.
- 기본 도구: 웹 검색, 로컬 검색, 코드 인터프리터,
get_flight_status같은 도메인 함수 - 특화 LLM: 수학 모델, 코드 작성 모델
- 범용 LLM: GPT-5, Claude Opus 4.1 등
모든 도구는 이름, 설명, 타입이 지정된 파라미터를 담은 JSON 스키마라는 하나의 인터페이스로 노출됩니다. LLM을 도구로 쓸 때는 해당 모델이 학습 과제 10개를 푼 궤적과 성공 여부를 다른 LLM에 보여 주고, 그 모델의 강점과 약점을 서술한 설명문을 쓰게 합니다. 오케스트레이터는 이 설명문을 읽고 어떤 모델에 무엇을 맡길지 판단합니다.
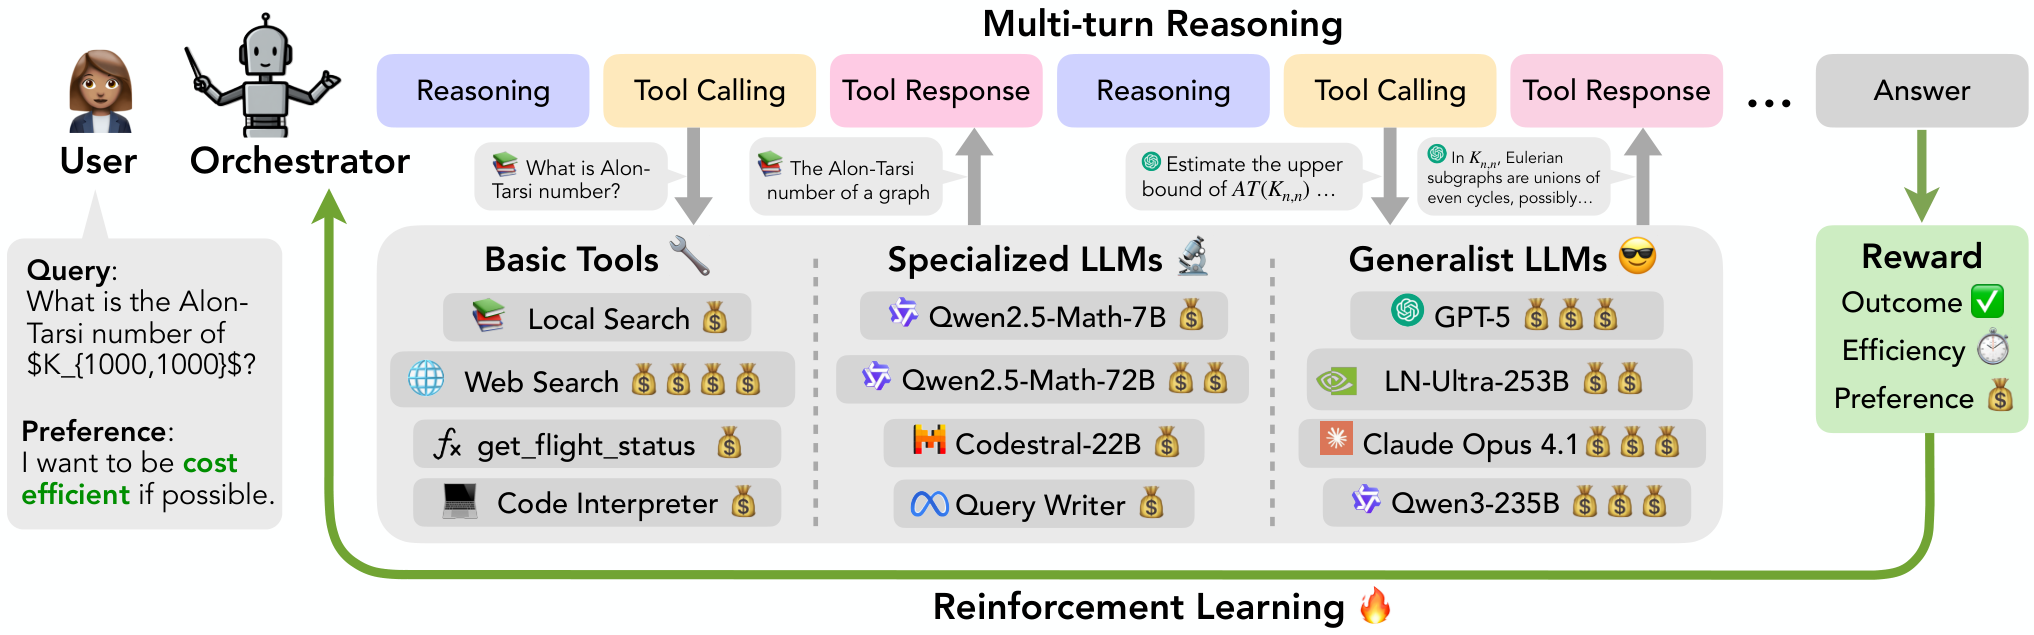
이 구조도에서는 한 턴이 순환 구조라는 점에 주목하면 됩니다. 각 턴에서 모델은 체인 오브 소트로 다음 행동을 계획하고, 도구를 골라 파라미터를 채워 호출한 뒤, 그 결과를 관찰로 받아 다음 턴으로 넘어갑니다. 이 과정은 종료 신호가 오거나 최대 50턴에 이를 때까지 반복됩니다.
⚙️ 제안한 방법은 어떻게 구현되었습니까?
보상 설계. 궤적 \(\tau\)마다 세 가지 신호를 계산합니다.
- 이진 정답 보상 \(r_{\text{outcome}}(\tau)\in\{0,1\}\): GPT-5를 판정자로 사용합니다.
- 비용 보상 \(r_{\text{compute}}(\tau)=-\$(\tau)\): 입력·출력 토큰을 제3자 API 가격으로 환산한 금액입니다.
- 지연 보상 \(r_{\text{latency}}(\tau)=-\mathit{Clock}(\tau)\): 실제 경과 시간입니다.
여기에 도구별 호출 횟수 \(m_{t_i}^{\tau}\)를 더해 벡터 \(M^{\tau}=[m^{\tau}_{t_1},\ldots,m^{\tau}_{t_n},r_{\text{outcome}},r_{\text{compute}},r_{\text{latency}}]\)를 만듭니다. 각 성분은 롤아웃 배치 \(\mathrm{T}\) 안에서 최소-최대 정규화합니다. 배치 안에서 값이 모두 같은 성분은 0으로 둡니다.
\[M^{\tau}_{\text{norm}}[k]=\frac{M^{\tau}[k]-M^{\mathrm{T}}_{\min}[k]}{M^{\mathrm{T}}_{\max}[k]-M^{\mathrm{T}}_{\min}[k]}\]최종 보상은 정규화된 벡터와 사용자 선호 벡터 \(P=[p_{t_1},\ldots,p_{t_n},p_{\text{outcome}},p_{\text{compute}},p_{\text{latency}}]\) (\(0\le p_\bullet\le 1\))의 내적입니다. 단, 과제를 풀지 못한 궤적의 보상은 0입니다.
\[R(\tau)=\begin{cases} M^{\tau}_{\text{norm}}\cdot P & \text{if } r_{\text{outcome}}(\tau)=1\\ 0 & \text{otherwise}\end{cases}\]비용 항은 음수이므로, 정규화하면 배치에서 가장 싼 궤적이 1, 가장 비싼 궤적이 0이 됩니다. 이해를 돕기 위한 가상의 수치로 예를 들면, 같은 배치의 정답 궤적 셋이 각각 $0.10, $0.30, $0.50를 썼다면 비용 성분은 1, 0.5, 0이 됩니다. \(p_{\text{compute}}=1\)이면 가장 싼 정답 궤적이 가장 큰 보상을 받습니다. 사용자가 "로컬 검색을 선호한다"고 밝히면 해당 도구의 \(p_t\)가 1이 되어, 그 도구를 많이 쓴 궤적이 우대됩니다.
핵심: 실패한 궤적은 보상이 무조건 0이므로, 비용과 선호는 "정답을 맞힌 궤적끼리" 경쟁할 때만 작동합니다. 정확도를 희생해 비용을 줄이는 쪽으로 정책이 무너지지 않도록 막는 장치입니다.
학습 절차. 최적화는 GRPO로 합니다. 같은 과제에서 생성한 궤적 그룹 안에서 이점(advantage)을 \(A(\tau)=(R(\tau)-\text{mean}\,R)/\text{std}\,R\)로 정규화하고, 클리핑된 대리 목적함수를 최대화합니다. 학습 안정화와 KL 손실 폭주 방지를 위해 세 종류의 샘플을 역전파에서 제외합니다. 보상 표준편차가 0.1 미만인 배치, 도구 호출 형식이 어긋난 출력, 유효한 답이 없는 출력입니다.
데이터와 일반화 장치. 검증 가능한 다중 턴 도구 사용 데이터가 부족해서 저자들은 합성 데이터셋 ToolScale을 만들었습니다.
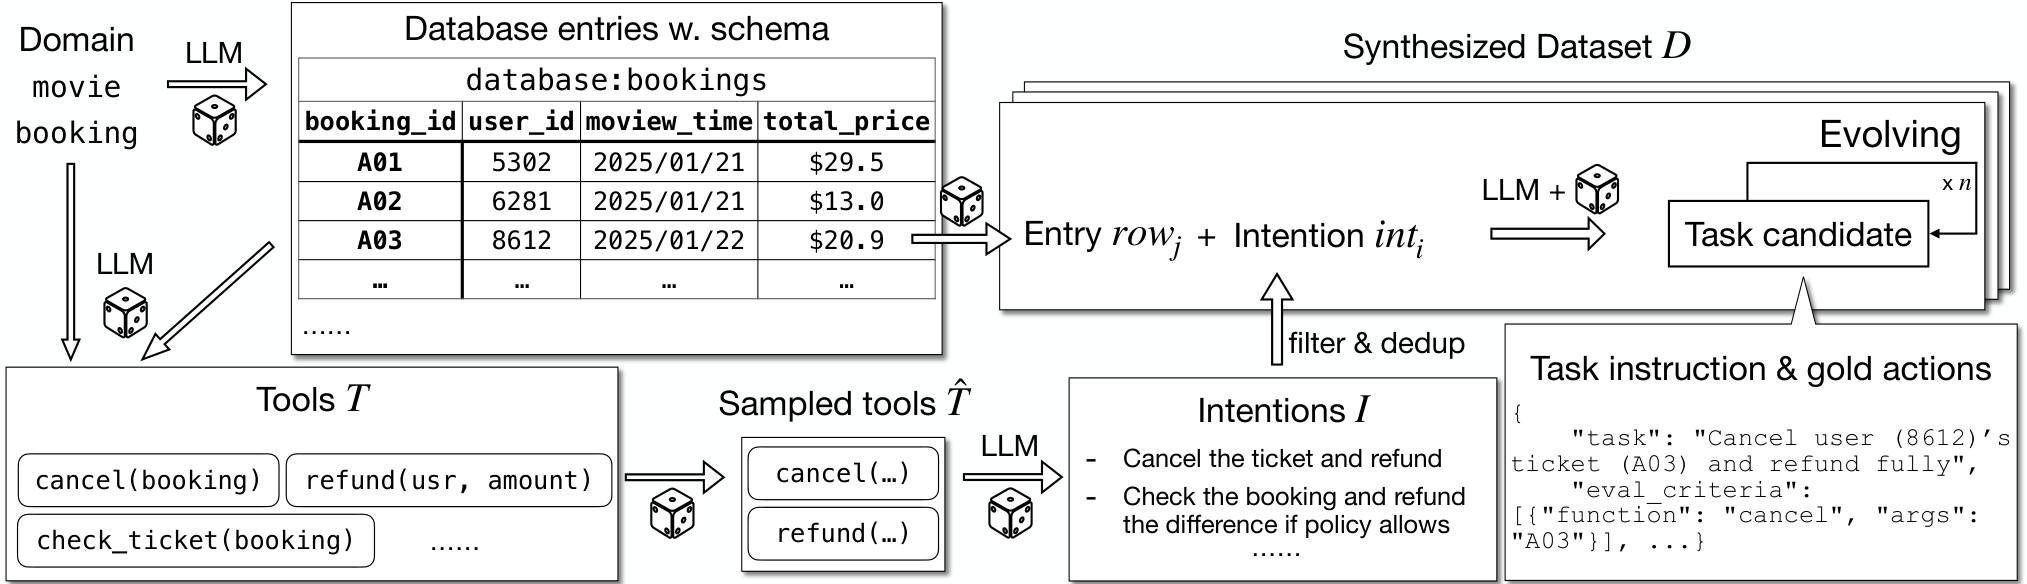
이 파이프라인은 두 단계입니다. 먼저 LLM이 도메인별 데이터베이스 스키마, 레코드, 도구 API를 생성해 환경을 만듭니다. 이어서 의도를 제안하고, 이를 정답 함수 호출이 딸린 구체적 과제로 바꾼 뒤, 제약을 추가해 난이도를 높입니다. 다음 세 가지 경우는 걸러 냅니다. 정답 호출을 실행하면 오류가 나는 과제, LLM이 pass@8로도 풀지 못하는 과제, 행동 없이도 풀리는 과제입니다. 결과는 금융, 의료, 철도 등 10개 도메인에 도메인별 247~622개, 합계 4,063개 과제입니다.
과제 성공은 세 조건을 모두 만족해야 인정됩니다. 실행 후 데이터베이스 상태가 정답과 일치해야 하고, 필수 정보를 언급해야 하며, 정답이 다룬 레코드를 모두 다뤄야 합니다. 여기에 LLM이 만든 (선호 지시문, 선호 벡터) 쌍을 과제에 붙입니다. 또 학습 인스턴스마다 사용 가능한 도구의 부분집합과 가격표를 무작위로 바꿔, 특정 도구 구성에 과적합하지 않도록 합니다. 학습 데이터에는 GeneralThought-430K도 함께 쓰며, 학습률은 1e-6이고 H100 16장을 사용했습니다.
📊 핵심 실험 결과는 무엇입니까?
평가는 HLE(텍스트 전용 부분집합), FRAMES, τ²-Bench에서 했습니다. 도구 집합은 모든 모델에 동일하게 고정했고 온도는 0입니다. 비용(센트)과 지연(분)은 HLE와 FRAMES의 평균입니다. 아래 표는 원 논문 표 중 주요 행만 추렸습니다(일부 행 생략).
| 구분 | HLE | FRAMES | τ²-Bench | 비용 | 지연 |
|---|---|---|---|---|---|
| GPT-5 (도구 없음) | 23.4 | 66.3 | – | 6.2 | 4.1 |
| GPT-5 (기본 도구) | 35.1 | 74.0 | 77.7 | 30.2 | 19.8 |
| Qwen3-8B (전체 도구·모델) | 30.6 | 68.9 | 72.3 | 27.6 | 18.3 |
| Qwen3-235B-A22B (전체 도구·모델) | 32.8 | 74.2 | 75.6 | 29.7 | 21.2 |
| Claude Opus 4.1 (전체 도구·모델) | 34.6 | 72.8 | 76.8 | 52.5 | 25.6 |
| GPT-5 (전체 도구·모델) | 21.2 | 57.5 | 62.3 | 17.8 | 13.6 |
| Orchestrator-8B (전체 도구·모델) | 37.1 | 76.3 | 80.2 | 9.2 | 8.2 |
더 적은 비용으로 더 높은 정확도
Orchestrator-8B는 세 벤치마크 모두에서 가장 높은 점수를 냈습니다. 가장 강한 기준선인 GPT-5(기본 도구)와 비교하면, 평균 비용은 30.2센트에서 9.2센트로 약 3분의 1 수준이고 지연은 19.8분에서 8.2분으로 줄었습니다. 같은 백본인 Qwen3-8B를 프롬프트만으로 오케스트레이터로 쓰면 HLE가 30.6에 그쳐, 37.1과의 차이는 학습에서 나온 것으로 볼 수 있습니다. 흥미롭게도 GPT-5는 모델까지 도구로 주면 오히려 21.2로 떨어집니다. 저자들은 그 이유로 GPT-5-mini에 의존하는 편향을 듭니다.
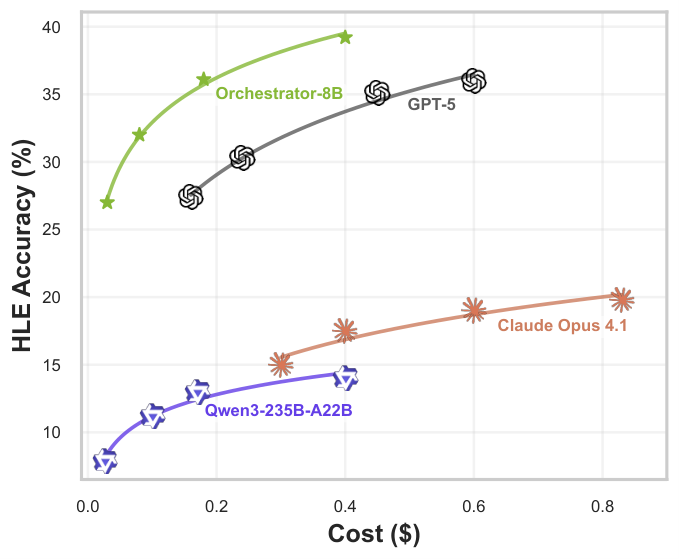
최대 턴 수를 10, 20, 50, 100으로 바꾼 이 곡선에서는 Orchestrator-8B 곡선이 모든 예산 구간에서 GPT-5, Claude Opus 4.1, Qwen3-235B-A22B보다 위쪽에 있다는 점을 보면 됩니다. 인스턴스당 평균 GPT-5 호출 횟수도 Orchestrator-8B는 1.6회로, Claude Opus 4.1(6.2회)이나 Qwen3-235B-A22B(6.2회)보다 훨씬 적습니다.
처음 보는 도구와 가격 체계로의 일반화
학습 때 본 적 없는 모델들(Claude Sonnet 4.1, Codestral-22B, Gemma-3-27b 등)로 도구 구성을 바꿔도 Orchestrator-8B는 HLE 22.0, FRAMES 73.8, τ²-Bench 48.8로 모든 기준선보다 높았습니다. 비용은 34.8로 가장 낮았습니다. 비교하면 Claude Opus 4.1은 17.8 / 53.6 / 43.4점에 비용 102.4입니다. 학습에 쓰지 않은 deepinfra 가격표에서도 HLE 36.9, 비용 7.5로 우위가 유지되었습니다.
사용자 선호 준수
선호 지시문을 붙인 평가 세트에서 저자들이 정의한 선호 반영 보상은 Orchestrator-8B가 HLE 46.7, FRAMES 68.4, τ²-Bench 79.5였습니다. 차순위인 Claude Opus 4.1은 40.2 / 63.4 / 73.5, GPT-5는 34.6 / 62.3 / 70.3입니다.
🔮 이 연구의 의의와 한계는 무엇입니까?
이 연구는 "더 큰 단일 모델" 대신 "작은 지휘자가 여러 모델을 조합하는 복합 시스템"으로도 정확도와 효율을 동시에 끌어올릴 수 있다는 실증 근거를 제시합니다. 비용과 선호를 보상 벡터의 가중치로 넣는 설계는 단순합니다. 그런데도 사용자가 추론 시점에 정확도·비용·도구 선호의 균형을 조정할 수 있게 해 줘서 실용적입니다. 모델, 데이터(ToolScale), 코드가 공개된 점도 후속 연구에 도움이 됩니다.
한계도 분명합니다.
- 평가 조건의 차이: HLE는 텍스트 전용 부분집합에서만 평가했습니다. 저자들도 GPT-5의 τ²-Bench 보고치(84.2)를 재현하지 못하고 77.7을 얻었다고 밝혀, 기준선 구현 차이가 결과에 영향을 줄 수 있습니다.
- 기준선의 성격: 모델을 도구로 쓰는 기준선은 모두 프롬프트 기반이라, 학습된 다른 라우팅 방법과의 비교는 없습니다.
- 분석의 공백: 보상 구성요소별 기여를 분리한 실험과 실행 간 분산도 보고되지 않았습니다.
- 판정과 지표의 설계: 학습 보상의 정답 판정을 GPT-5가 맡고, 선호 평가 지표는 Qwen3-8B 대비 상대값으로 저자들이 따로 정의했습니다. 이 때문에 선호 준수 수치는 그 정의에 의존합니다.
- 성능의 원천: Orchestrator-8B의 성능은 GPT-5 같은 상용 모델 호출에 기대고 있습니다. 따라서 "8B 모델의 지능"이라기보다 시스템 전체의 성능이며, 비용 역시 특정 API 가격표를 기준으로 계산한 값입니다.
References
Subscribe via RSS